 iwai-chem
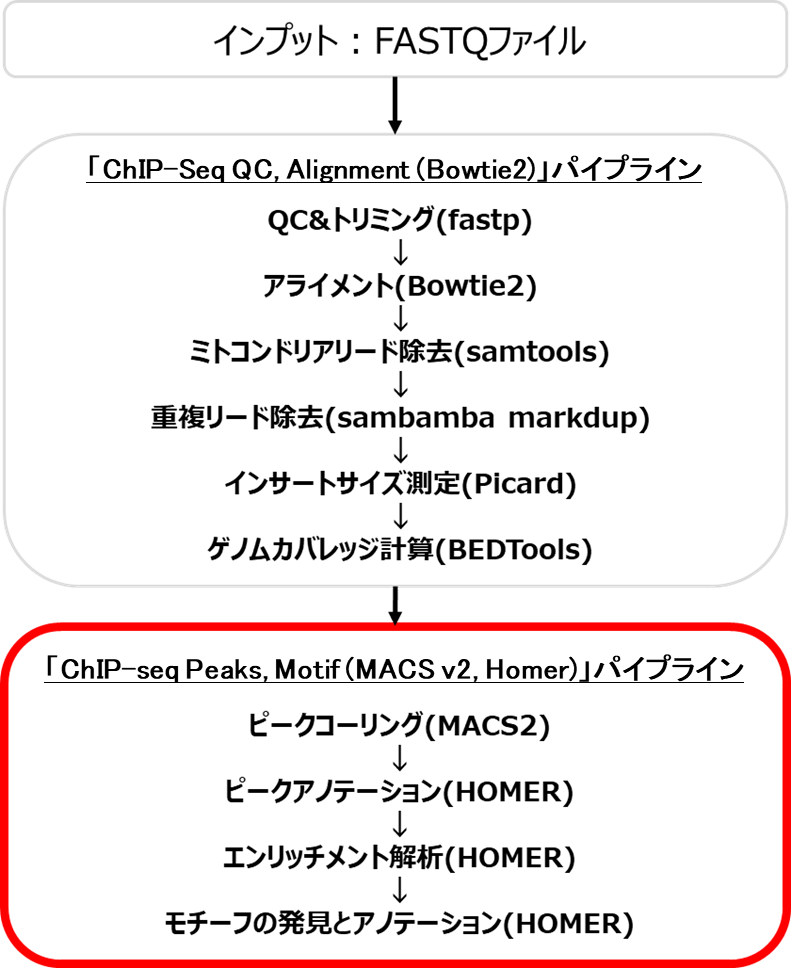
「ChIP-seq Peaks, Motif (MACS v2, Homer)」パイプラインを実行すると、最初に「ChIP-Seq Alignment (Bowtie2)」パイプラインが自動的に実行されます。このパイプラインから出力された重複リード除去済みのBAMファイルがモチーフ解析に使用されます。
このパイプラインではまず、MACS2を使用してピークコーリングが実行されます。その後、HOMERを使用してピークアノテーションとエンリッチメント解析、モチーフ解析を行います。
パイプラインのワークフロー
図1では、MACSパイプラインのワークフローを示しています。
ピークコーリング
このステップでは、MACS2を用いてアライメントされたリードがエンリッチされたゲノム領域を特定します。この領域はタンパク質 (転写因子やヒストンなど) の潜在的な結合位置を示しています。
ピークアノテーション
ここでは、HOMERを用いて同定されたピークをゲノムの特徴 (プロモーターやエンハンサーなど) と関連付けます。ピークアノテーションは結合部位の機能的関連性を理解するために役立ちます。
エンリッチメント解析
HOMERを用いて、特定の生物学的パスウェイや遺伝子セットがタンパク質結合領域にエンリッチされているかどうかを判定します。
モチーフの探索とアノテーション
モチーフとは、検出されたピークの中に見られる短いDNA配列の特徴的なパターンのことです。これらのモチーフは転写因子やDNA結合タンパク質などのタンパク質がDNAに結合する標的配列を表しています。
まず、統計的に有意に多く出現するモチーフがHOMERを用いて同定されます。これらのモチーフは次に、既知のモチーフにアノテーションされます。
結果 (「Report」タブ)
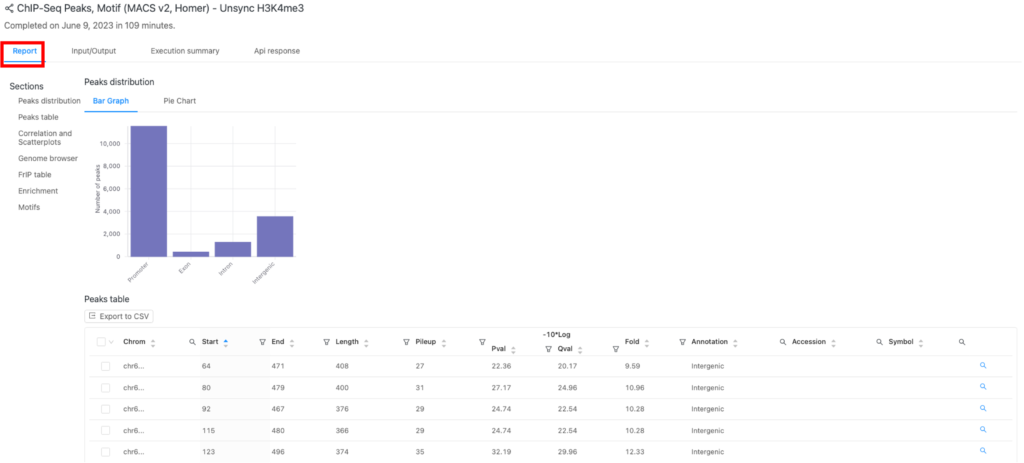
結果は、「Report」タブ (図2の赤枠) にあります。
Peaks distribution
図3のaとbは、それぞれピーク分布解析から得られた棒グラフと円グラフです。
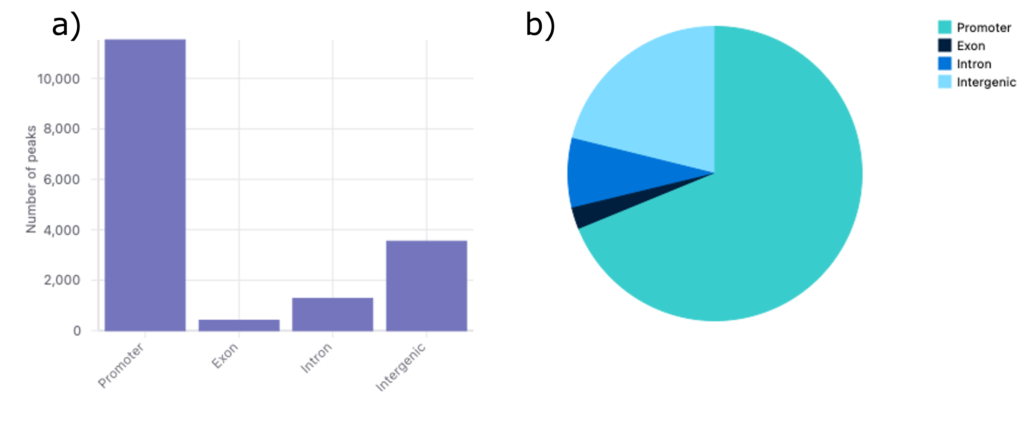
棒グラフ (図3a) は、検出されたピークの数をゲノム領域別に表しています。それぞれのピークは、転写因子など目的のタンパク質がDNAのプロモーター、エクソン、イントロン、あるいは遺伝子間領域のどこと結合するかを示します。
この例では、ピークの大部分はプロモーター領域に見られます (~12,000箇所)。これは、転写開始点 (TSS) 付近にタンパク質が多く結合していることを示しています。
また、多数のピークが遺伝子間領域に見られます (~3,000箇所)。これは非コード領域における制御エレメントの結合を表しています。制御エレメントには、エンハンサーやサイレンサーが含まれます。
さらに、エクソン (~500箇所) およびイントロン (~1,000箇所) におけるピーク数は比較的少数です。これは、今回のターゲットタンパク質が、遺伝子内部の領域よりも、発現制御に関わる領域に対してより高い選択性を持って結合していることを示唆しています。 図3bの円グラフは、同じデータについて、各ゲノム領域におけるピークの比率を示したものです。ピークの数は棒グラフと一致しています。
Peaks table
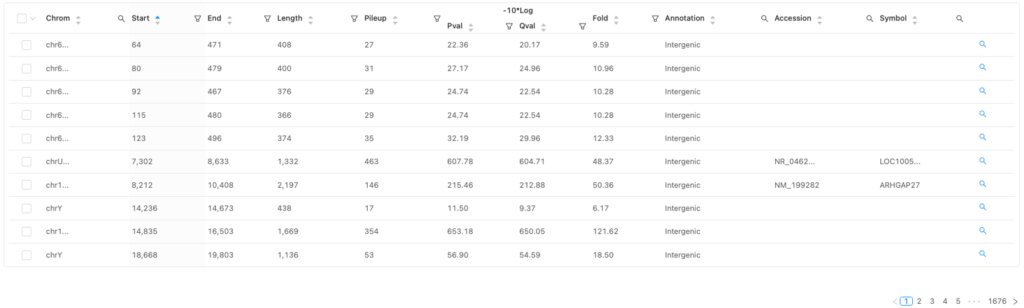
図4では、同定されたピークとその近傍のアノテーション遺伝子を示しています。
用語
| 用語 | 定義 |
| Chrom, Start, End, Length | ゲノム上の位置とピークの大きさ |
| Pileup | ピーク頂上のゲノム位置にアライメントされたリード数 |
| Pval | ピークの統計的な有意性 ( -10 * log10 ) |
| Qval | 偽発見率 (FDR) で補正した統計的な有意性 ( -10 * log10) |
| Fold | ピークの濃縮倍率 バックグラウンドに対してどれくらいエンリッチしているかを表す |
| Annotation | ピークが位置するゲノムの特徴 |
| Accession | ピークに最も近い遺伝子のID |
| Symbol | ピークに最も近い遺伝子の記号・名前 |
Correlation and scatterplots
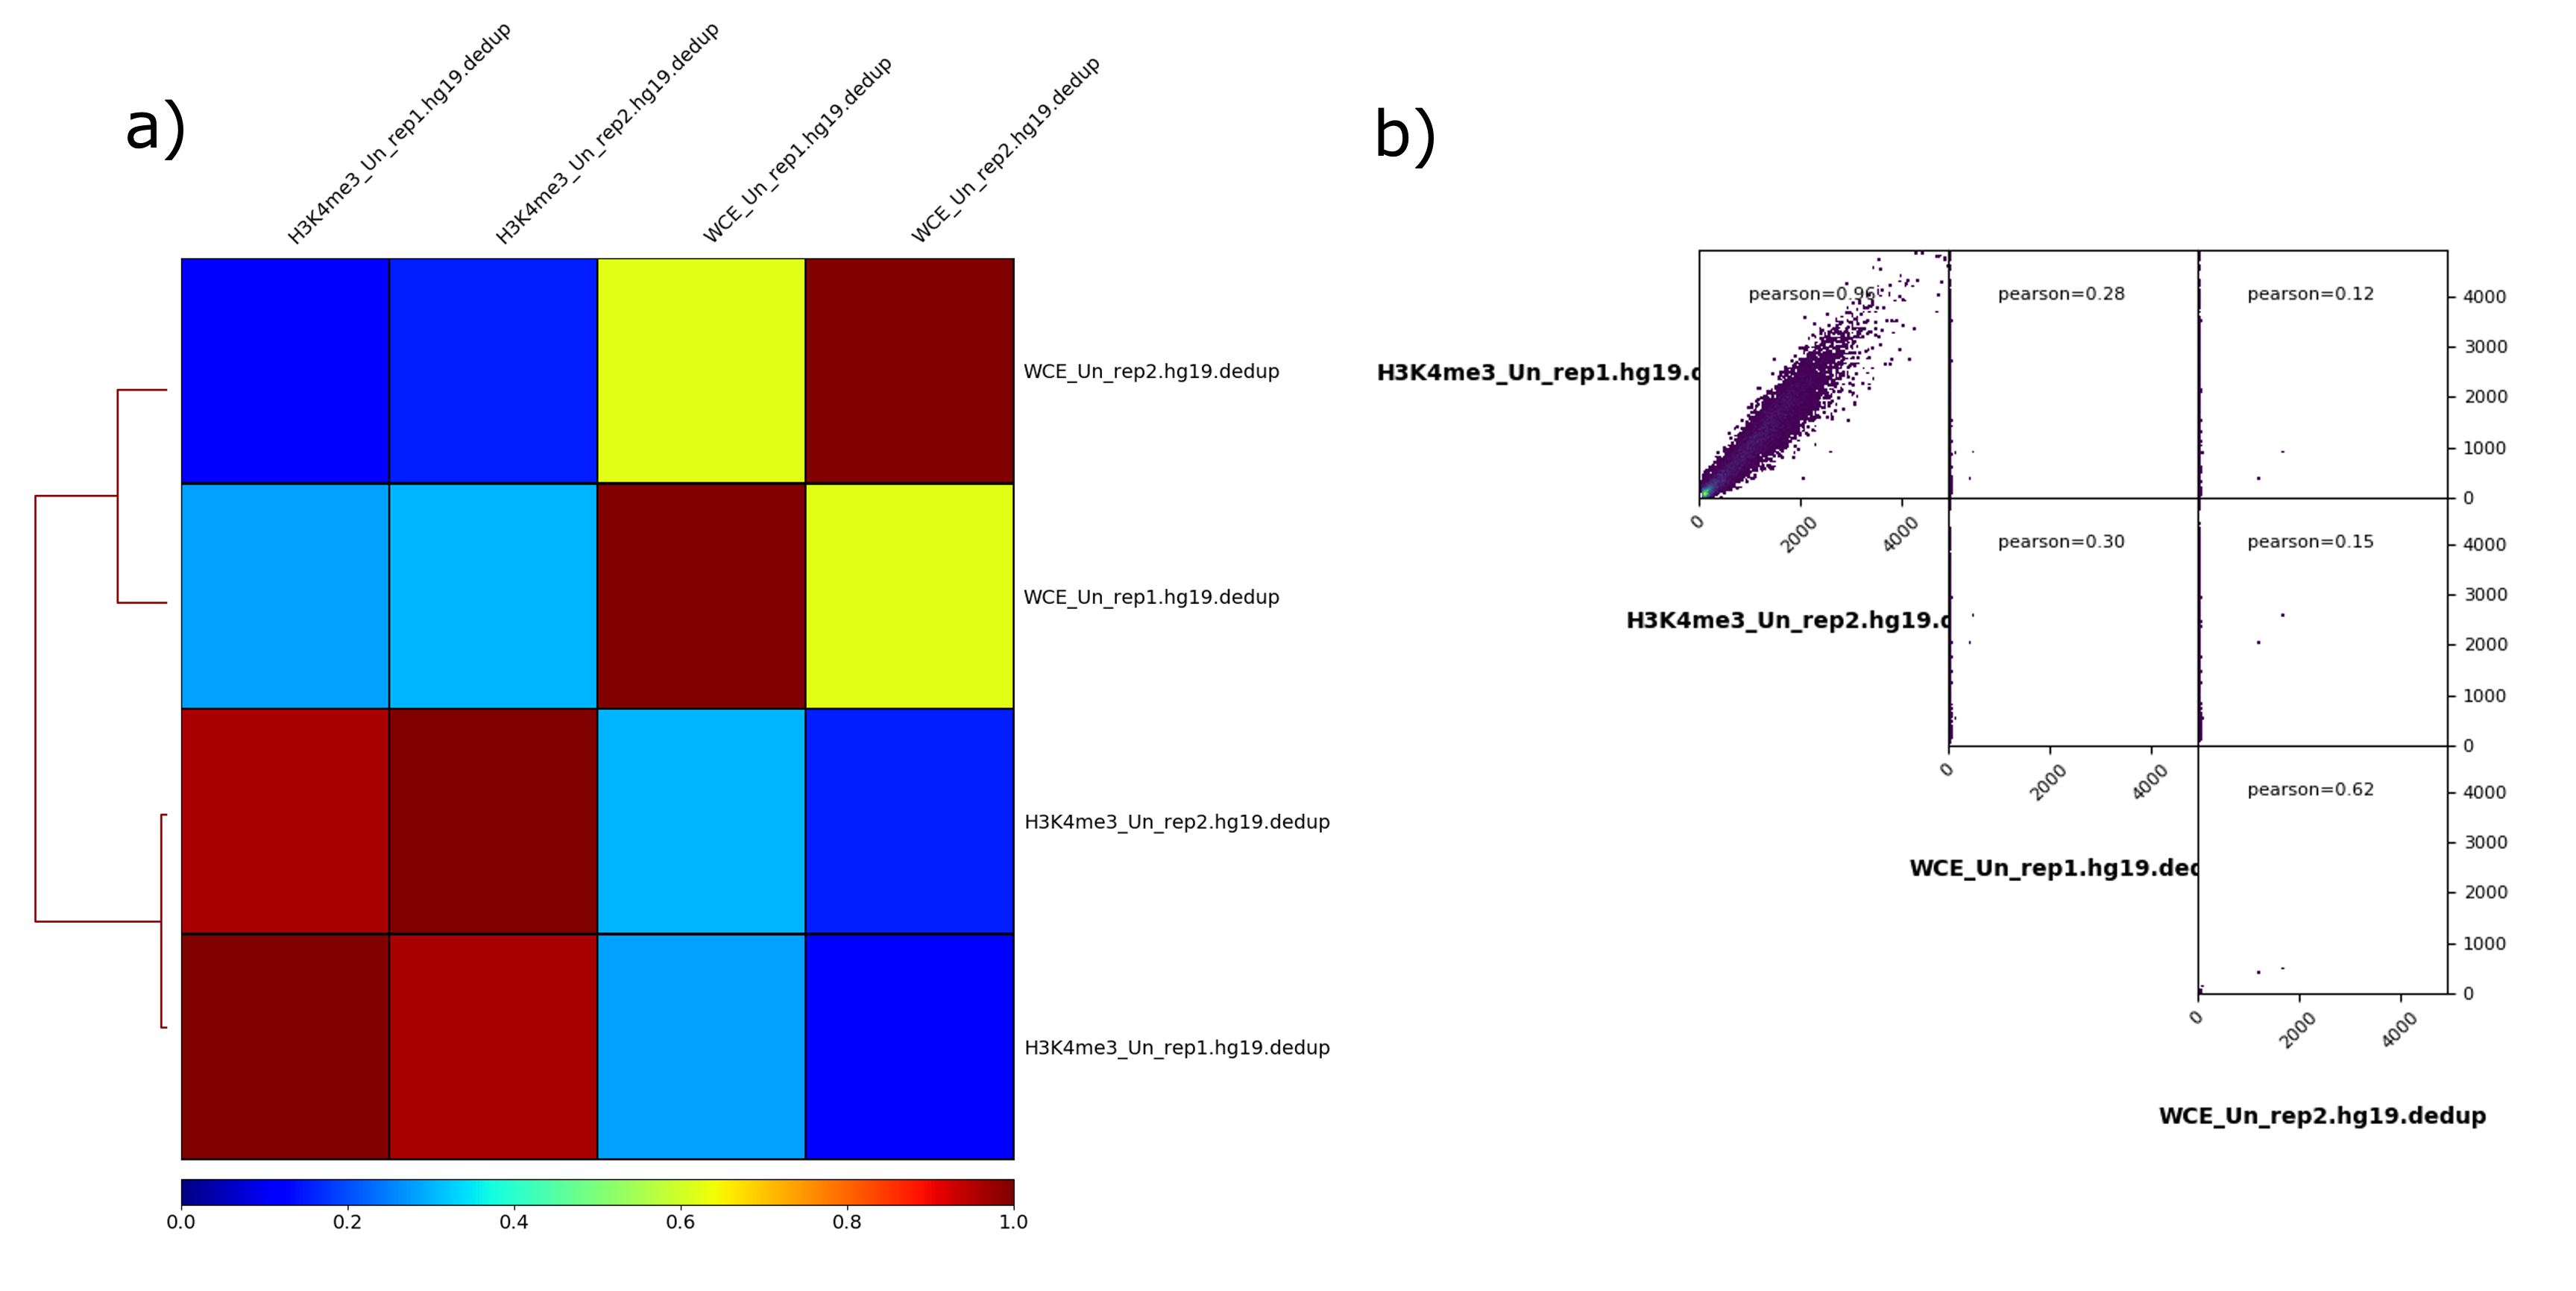
相関解析から得られたヒートマップと散布図を図5aと図5b に示します。
ヒートマップ
図5aのヒートマップでは、異なるサンプル間の相関が比較されています 。ヒートマップの各セルは、2つのサンプル間の相関を示しており、青 (0に近い) は相関が弱く、赤 (1に近い) は相関が強いことを表します。左のデンドログラムは階層的クラスタリングの結果を示しています。すなわち、プロファイルがより類似しているサンプルがグループ化されています。
さらに、図5aでは、レプリケートサンプルの間のヒートマップの色の違いが観察でき、H3K4_rep1とH3K4_rep2では赤色、つまり強い相関があることがわかります。これは、2つのサンプルが非常に類似しており、再現性が高いことを示しています。一方、WCE_rep1とWCE_rep2間では黄色、つまり相関が中程度であることがわかります。
散布図
図5bの散布図では、サンプルのペア間のシグナル強度を示しています。各散布図は2つのサンプル間の関係を表します。各ポイントは、特定のゲノム上の位置 (例えば、ピークやターゲット領域) における2つのサンプル間の比較を表します。ピアソン相関係数は各散布図の上に表示され、2つのサンプル間の類似性を数値で示します。
ピアソン相関係数が1に近いほど、2つのサンプル間のシグナル強度がより類似していることを示します。ヒートマップの結果 (図5a) と同様に、H3K4me3のレプリケートのシグナル強度の相関 (pearson = 0.96) は、WCEのレプリケート (pearson = 0.62) に比べて強いことがわかります。これは、強いシグナルが出ている箇所においてH3K4me3のレプリケートの再現性が高いことを示唆しています。
Genome browser
図6では、Integrative Genomics Viewer (IGV) でシグナル強度を視覚化した例を示しています。
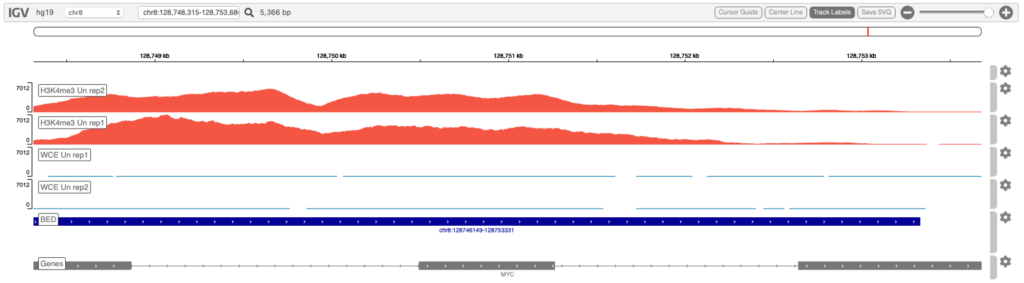
検索ボックスで、間にスペースを入れて複数の遺伝子を指定することで、並べて可視化することができます。
例えば以下の図7のような表示にできます。

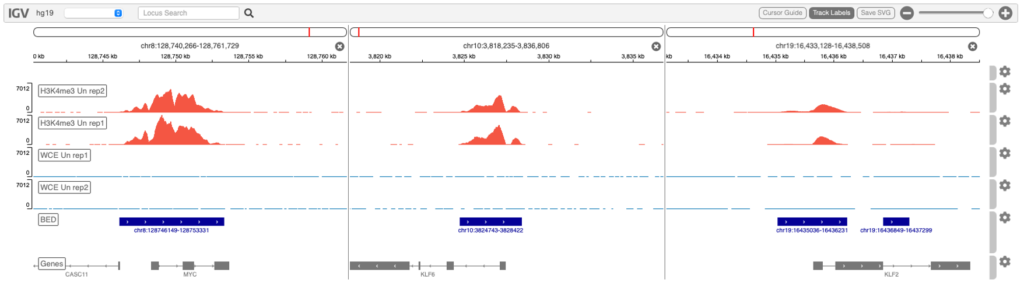
図7. IGVにおける表示例
FRiP table
FRiP (Fraction of Reads in Peaks) は、実験のクオリティを評価する指標です。
FRiPは、同定されたピークにマップされたリード数を、解析対象となる総リード数で割ることによって算出されます:
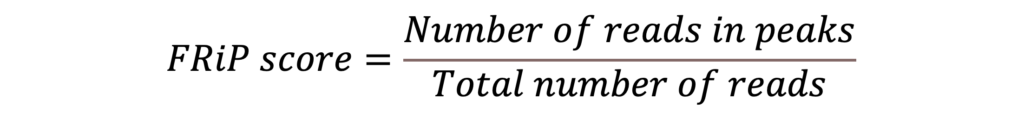
一般的に、FRiPスコアが高いほど、標的タンパク質が結合するDNA領域へのリードのエンリッチメントが高く、バックグラウンドノイズが少ないことを示します。

図8には、解析に用いた全サンプルのFRiPスコアを示します。H3K4me3 (ヒストン修飾) のレプリケートのFRiPスコアは約0.7です (約70%のリードがピーク内に含まれている)。これは、H3K4me3ヒストン修飾のエンリッチメントが高いことを示唆しています。
一方、WCE (コントロール) のレプリケートのFRiPスコアは約0.01です (約1%のリードがピーク内に含まれている)。WCEのレプリケートは、特定のヒストン修飾やタンパク質をターゲットとしないため、高いエンリッチメントは期待できません。この結果は予想通りの妥当なものです。
Enrichment
図9では、ピークに関連する遺伝子のエンリッチメント解析結果を示します。
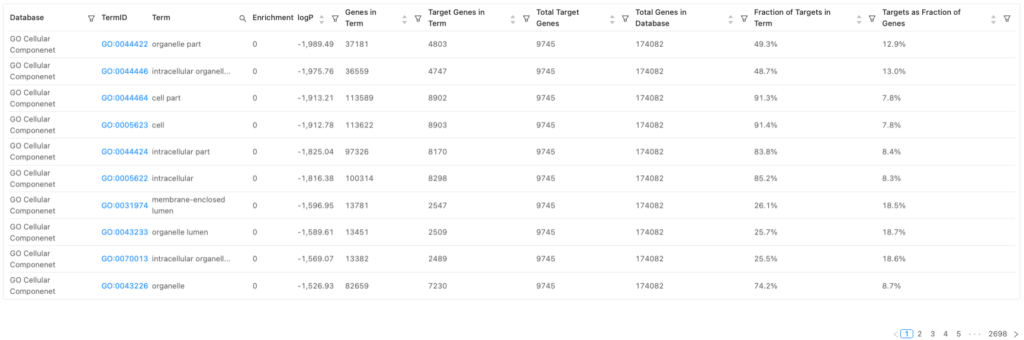
用語
| 用語 | 定義 |
| Database | エンリッチメント解析で使用される遺伝子セットのデータベース |
| TermID | 遺伝子セットのデータベースにおける固有の識別子 |
| Term | 遺伝子セットの名前 |
| Enrichment logP | 遺伝子セットのエンリッチメントの有意性 (対数変換したp値) |
| Genes in Term | 遺伝子セットに含まれる遺伝子の総数 |
| Target Genes in Term | データセットと遺伝子セットの間で共通の遺伝子の数 |
| Total Target Genes | データセットに含まれる遺伝子の総数 |
| Total Genes in Database | 遺伝子セットのデータベースに含まれる総遺伝子数 |
| Fraction of Targets in Term | データセットに含まれる全遺伝子数の内、遺伝子セットで共通する遺伝子の割合 (Target Genes in Term / Total Target Genes) |
| Targets as Fraction of Genes | 遺伝子セットに含まれる全遺伝子の内、データセットに含まれる遺伝子の割合 (Target Genes in Term / Genes in Term) |
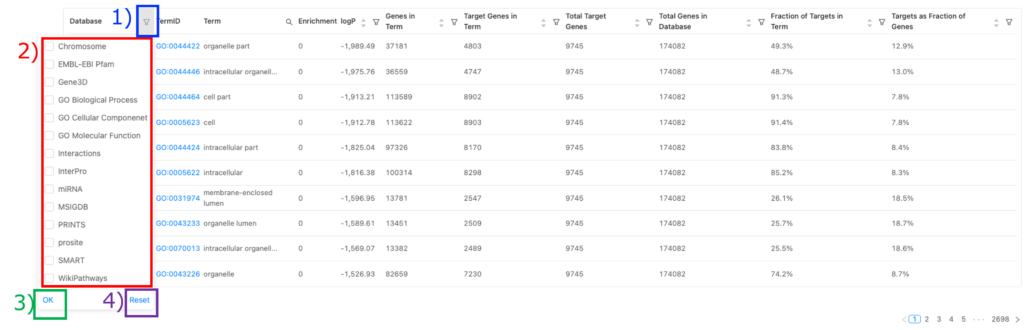
エンリッチメント解析に使用するデータベースの変更方法:
1) Enrichment の「Database」タブにある「filter」アイコンをクリックしてください。
2) データベースをチェックしてください。
3) 「OK」をクリックしてください。
4) デフォルトのデータベース (例:GO Cellular Component) に戻りたい場合は、「Reset」をクリックし、チェックしたすべてのデータベースのチェックを外してください
Motifs
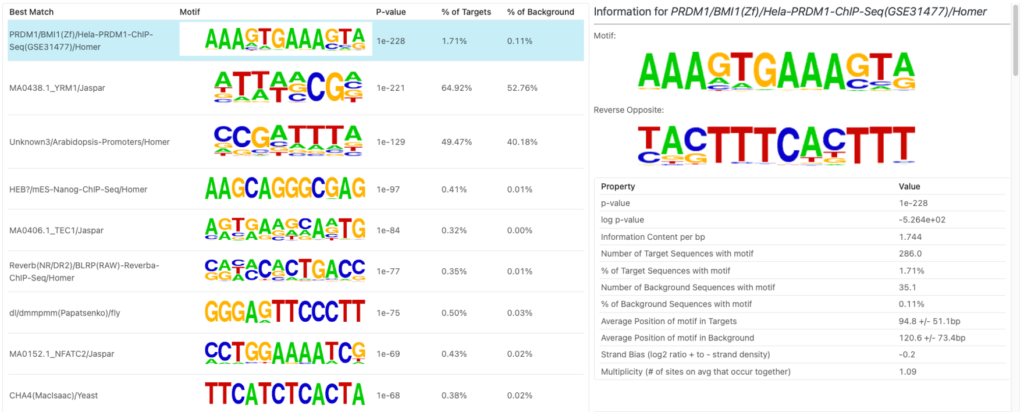
図10には、ピークでエンリッチされたモチーフのサマリーと、それらにマッチする転写因子結合プロファイルを示します。
用語
| 用語 | 定義 |
| Best Match | 発見されたモチーフに最も類似した既知のモチーフまたは転写因子結合プロファイル |
| Motif | 発見されたモチーフの配列ロゴ 背の高い文字は、その位置のヌクレオチドの保存性が高いことを示します |
| p-value | モチーフエンリッチメントの統計的有意性 |
| % of Targets | モチーフを含むピーク領域 (ターゲット) の割合 |
| % of Background | モチーフを含むバックグラウンド領域 (非ピーク領域) の割合 |
図10の左側のモチーフ (例えば、PRDM1) をクリックすると、そのモチーフの詳細なサマリーが右側に表示されます。図10のエンリッチされたモチーフの詳細については、テクニカルノート「basepair上のエピジェネティクスデータのモチーフ探索とアノテーション」をご参照ください。
アウトプットファイル (「Input/output)タブ)
パイプラインによって生成されたすべてのアウトプットファイルは、「Input/output」タブ (赤枠) にあります。
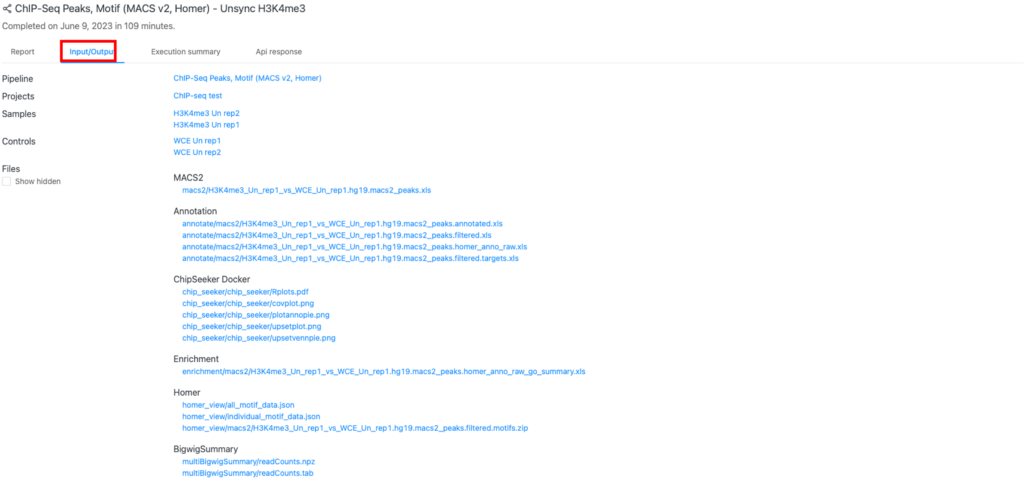
MACS2
- MACS2から出力されたピークコールの生データ (Excel形式)
(macs2/<ANALYSIS_NAME>.<genome>.macs2_peaks.xls)
Annotation
- 近傍遺伝子情報が付加された全ピークリスト (Excel形式)
(annotate/macs2/<ANALYSIS_NAME>.<genome>.macs2_peaks.annotated.xls)
- 解析に適さないブラックリスト領域除外後のピークリスト (Excel形式)
(annotate/macs2/<ANALYSIS_NAME>.<genome>.macs2_peaks.filtered.xls)
- HOMERにより同定されたピークとそのアノテーション (Excel形式)
(annotate/macs2/<ANALYSIS_NAME>.<genome>.macs2_peaks.homer_anno_raw.xls)
- HOMERでフィルタリングされたピークとそのアノテーション (Excel形式)
(annotate/macs2/<ANALYSIS_NAME>.<genome>.macs2_peaks.filtered.targets.xls)
ChipSeeker Docker
- DNA上の特定の領域に近接したピークの割合を示す円グラフ (PDF形式)
(chip_seeker/chip_seeker/Rplots.pdf)
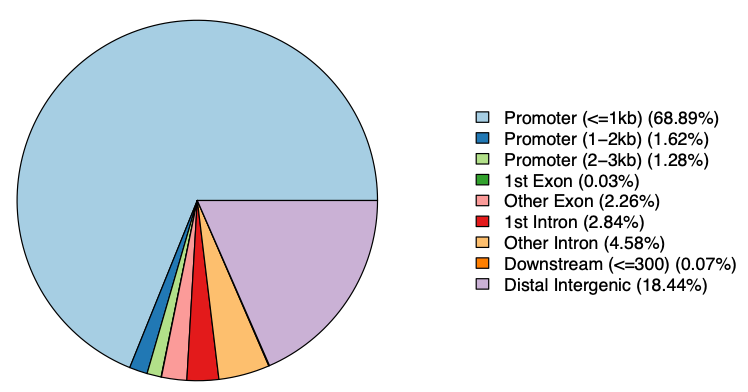
- 各染色体上で見つかったピークを可視化したグラフ (PNG形式)
(chip_seeker/chip_seeker/covplot.png)
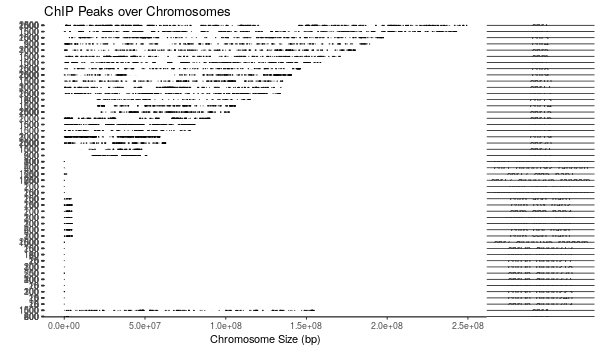
- DNA上の領域の包含関係に基づき、それぞれに近接したピークの割合を示す円グラフ (PNG形式)
(chip_seeker/chip_seeker/plotannopie.png)
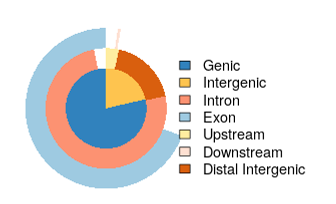
- DNA上の特定の領域に近接したピークのアップセットプロット (PNG形式)
(chip_seeker/chip_seeker/upsetplot.png)
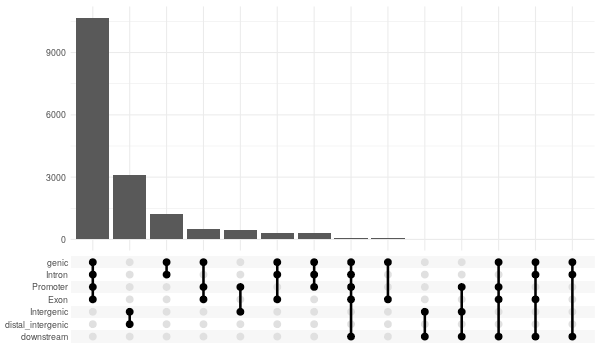
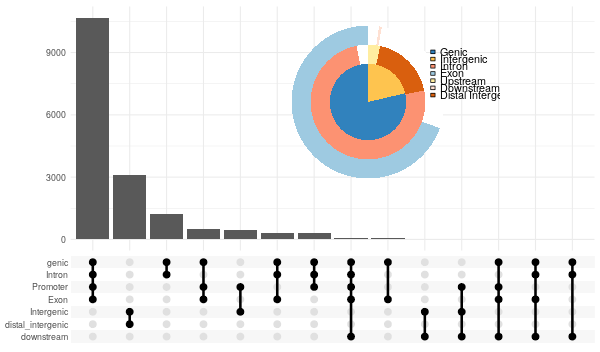
- 円グラフとアップセットプロットを組み合わせた図 (PNG形式)
(chip_seeker/chip_seeker/upsetvennpie.png)
Enrichment
- HOMERによる遺伝子オントロジーエンリッチメント解析の結果 (Excel形式)
(enrichment/macs2/<ANALYSIS_NAME>.<genome>.macs2_peaks.homer_anno_raw_go_summary.xls)
Homer
- 解析で同定されたすべてのモチーフのデータ (JSON形式)
(homer_view/all_motif_data.json)
- 解析で同定された個々のモチーフのデータ (JSON形式)
(pagehomer_view/individual_motif_data.json)
- 解析結果の圧縮フォルダ
(pagehomer_view/macs2/<ANALYSIS_NAME>.<genome>.macs2_peaks.filtered.motifs.zip)
BigwigSummary
- 各サンプルにおける領域別リードカウントデータの圧縮ファイル (NPZ形式)
(multiBigwigSummary/readCounts.npz)
- 各サンプルにおける領域別リードカウントデータ (タブ区切り形式)
(formatmultiBigwigSummary/readCounts.tab)
Plot Correlation
- サンプル間の相関を示したマトリックス (タブ区切り形式)
(plotCorrelation_heatmap/outFileCorMatrix.tab)
- サンプル間の相関を示したヒートマップ (PNG形式)
(plotCorrelation_scatterplot/scatterplot.plotCorrelation.png)
PlotCorrelation
- サンプル間の相関を示した散布図 (PNG形式)
plotCorrelation_scatterplot/scatterplot.plotCorrelation.png
参考文献
関連ブログ
ChIP-seq解析 https://basepairtech.jp/analysis/chip-seq/