 iwai-chem
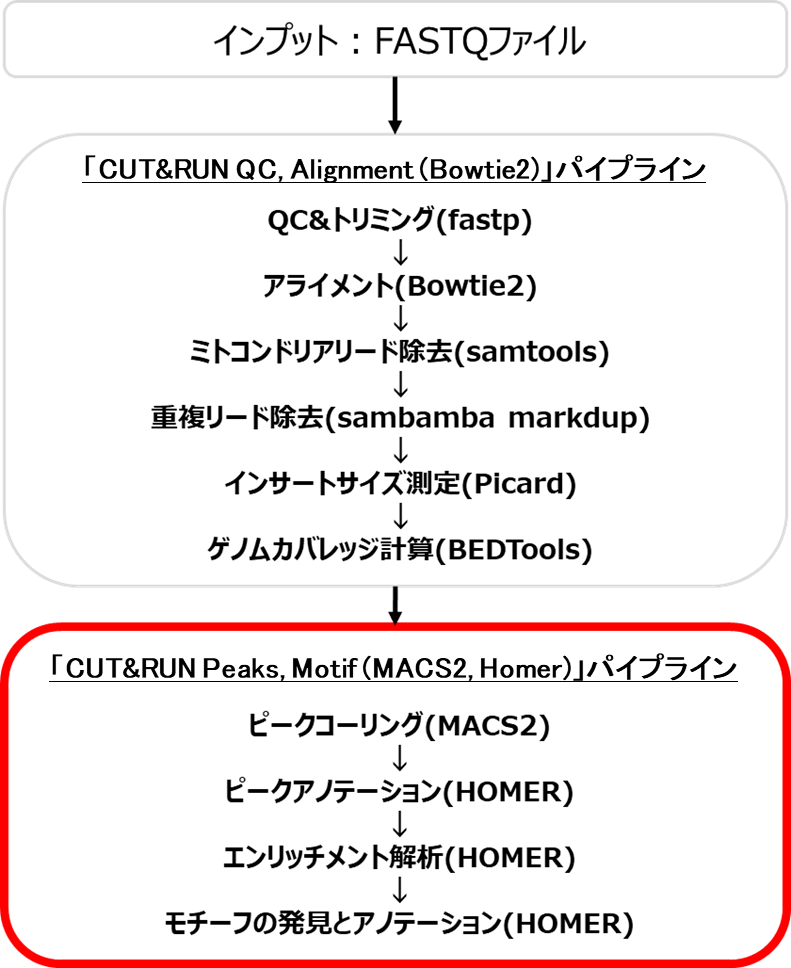
「CUT&RUN Peaks, Motif (MACS2)」パイプラインを実行すると、まず「CUT&RUN QC, Alignment (Bowtie2)」パイプラインが自動的に最初に実行されます。「CUT&RUN QC, Alignment (Bowtie2)」では、重複リード除去済みのBAMファイルがアウトプットされます。そして、このファイルを「CUT&RUN Peaks」のインプットとして使用します。そこでは、まずMACS2でピークコーリングが行われます。その後、HOMERでピークアノテーションとエンリッチメント解析、モチーフ解析を行います。
パイプラインのワークフロー
「CUT&RUN Peaks」パイプラインのワークフローを図1に示します。
ピークコーリング
MACS2を用いてアライメントされたリードがエンリッチされたゲノム領域を特定します。これらの領域は、タンパク質の潜在的な結合部位を示しています。
ピークのアノテーション
HOMERを用いて同定されたピークをゲノム上の特徴 (プロモーターやエンハンサーなど) と関連付けます。アノテーションされたピークや結合部位に関連する遺伝子のリストも一緒に作成されます。
エンリッチメント解析
HOMERを用いて、標的タンパク質の結合領域に特定の生物学的経路や遺伝子セットがエンリッチされているかどうかを判定するために実行されます。
モチーフの探索とアノテーション
モチーフとは、同定されたピーク内に見られる短いDNA配列のことです。これらのモチーフは、タンパク質がDNAと結合するゲノムの領域を表しています。ここでは、統計的に過剰に発現しているモチーフがHOMERを用いて同定されます。さらに、エンリッチされたモチーフは、既知のモチーフにアノテーションされます。このことは、どの転写因子が関与しているかを特定するのに役立ちます。
結果 (「Report」タブ)
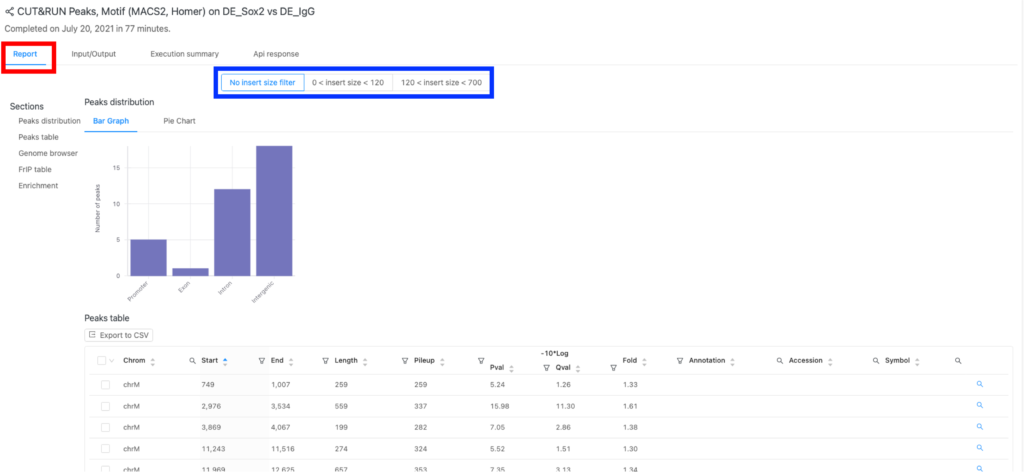
結果は、「Report」タブ (図2の赤枠) にあります。
ここでは、インサートサイズ (ペアエンドリード間のDNA断片の長さ) のフィルタリングに基づいて、3つのページが表示されます (図2の青枠) :
1) No insert size filter:フィルタリングが適用されません。
2) 0 < insert size < 120:インサートサイズが120塩基対より小さいDNA断片のみ選択します。小さいインサートサイズは、タンパク質とDNAが強く相互作用している領域を示します。
3) 120 < Insert Size < 700:インサートサイズが120から700塩基対のDNA断片を選択します。大きなインサートサイズは、より広範、あるいは特異的でない相互作用している領域を示します。
Peaks distribution
図3のaでは、異なるゲノム領域にわたるピークの分布を棒グラフで示しています。この領域にはプロモーター、エクソン、イントロン、遺伝子間領域が含まれます。 このグラフは、目的のタンパク質がゲノム内のどこに結合しやすいか、またそのタンパク質の役割の可能性を理解するのに役立ちます。
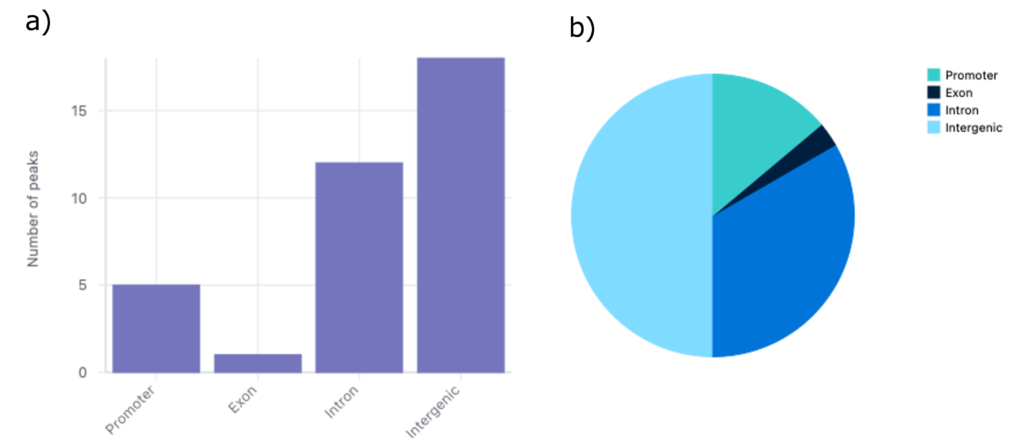
図3では、遺伝子間領域に最も多くのピーク(〜20)が見られます。この領域は、転写に直接関与しない遺伝子間の非コード領域のことです。また、イントロン領域(転写されるが翻訳前にスプライシングされる遺伝子内の非コード領域)においても多くのピーク(〜12)が見られます。転写を開始する遺伝子の上流領域であるプロモーターではピークが少ないです(〜5)。エキソン領域(転写されタンパク質に翻訳される遺伝子のコード領域)にはほとんどピークが見られません。
円グラフ (図3b) の結果は、棒グラフ (図3a) の結果と一致しています。
Peaks table
図4では、同定されたピークとその統計量、および近傍遺伝子のアノテーション示します。
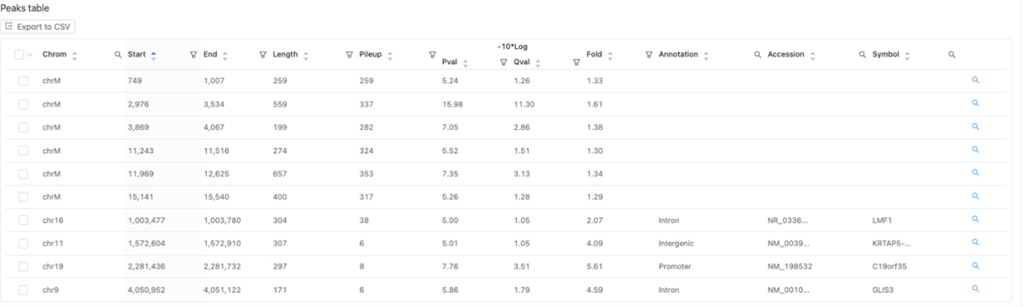
| 用語 | 定義 |
| Chrom, Start, End, Length | ゲノム上の位置とピークの大きさ |
| Pileup | ピーク頂上のゲノム位置にアライメントされたリード数 |
| Pval | ピークの統計的な有意性( -10 * log10 ) |
| Qval | 偽発見率(FDR)で補正した統計的な有意性( -10 * log10 ) |
| Fold | ピークのエンリッチメント度。バックグラウンドに対してどれくらいエンリッチしているかを表す |
| Annotation | ピークが位置するゲノムの特徴 |
| Accession | ピークに最も近い遺伝子のID |
| Symbol | ピークに最も近い遺伝子の記号・名前 |
Correlation and scatterplots
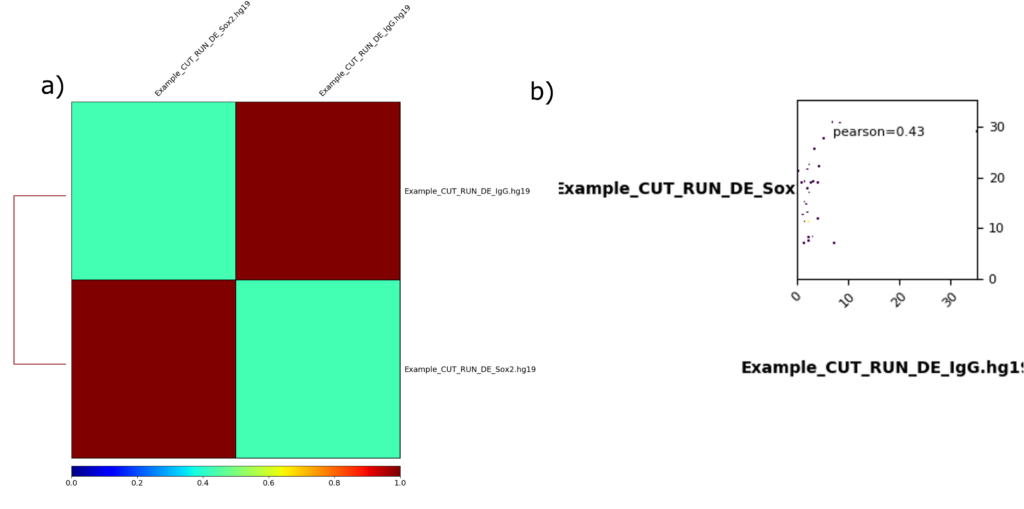
相関解析から得られたヒートマップと散布図をそれぞれ図5aと5bに示します。
ヒートマップ
ヒートマップ (図5a) では、異なるサンプル間の相関が比較されています。下部にあるカラースケールは相関の強さを示しています。青は相関が弱い低い、または相関がないことを、赤は相関が強いことを表します。
図、Sox2 (転写因子) とIgG (コントロール) のヒートマップにおける色の違いは、2つのサンプルに高いの相関が弱いことを示しています。これは一方が特定のターゲット (Sox2) で、もう一方がコントロール (IgG) である場合にみられます。
散布図
図5b の散布図では、サンプルペア間のシグナル強度を示しています。 x軸はIgGサンプルの値を表し、y軸はSox2サンプルの値を表します。散布図上の各点は、特定のゲノム上の位置 (例えば、ピークやターゲット領域) における2つのサンプル間の比較を表します。点の位置は、一方のサンプルのシグナル強度 (例えば、リードカウントまたは正規化スコア) が他方のサンプルのシグナル強度とどのように関連しているかを示します。グラフには、2つのサンプル間の相関を測定するピアソン相関係数の数値が含まれます (例えば、pearson = 0.43)。通常、係数は-1から1の範囲です。
図5bでは、ピアソン相関係数が0.43であり、Sox2とIgGサンプルの間に中程度の関係があることを示唆しています。つまり、ゲノム上でSox2が結合している領域のいくつかは、IgGコントロールでもシグナルを示す可能性があることを示しています。しかし、この相関はあまり強くなく、サンプルが異なることを示しています。この結果は、Sox2が転写因子であり、IgGがコントロールであることから想定されることです。
Genome browser
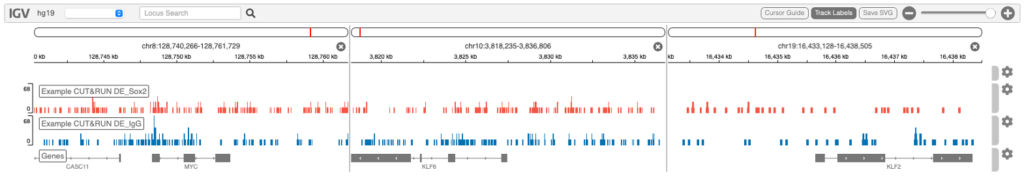
図6では、Integrative Genomics Viewer(IVG)に表示される正規化シグナルbigwigトラックの例を示します。
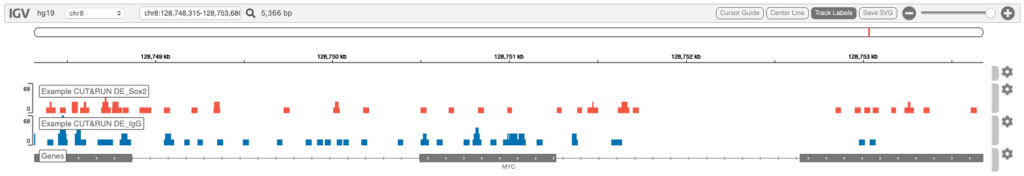
検索ボックスで、間にスペースを入れて複数の遺伝子を指定することで、並べて可視化することができます。
例えば以下の図7のような表示にできます。
FRiP table
FRiP (Fraction of Reads in Peaks) は、実験のクオリティを評価する指標です。FRiPは、同定されたピークにマップされたリード数を、リードの総数で割ることによって計算されます:
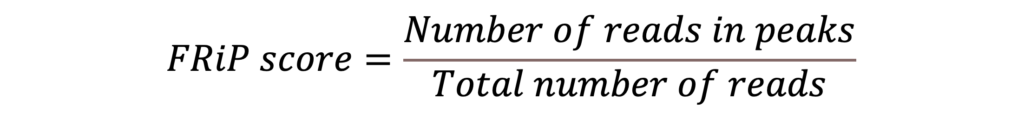
一般的に、FRiPスコアが高いほど標的タンパク質とDNAの相互作用が強くエンリッチされており、ピーク内のリードの割合が高いことを示します。

図8では、両サンプルともFRiPスコアは約0.005でした。つまり、アライメントされたリードの約0.5%のみがピーク内にあることを示しています。
Enrichment
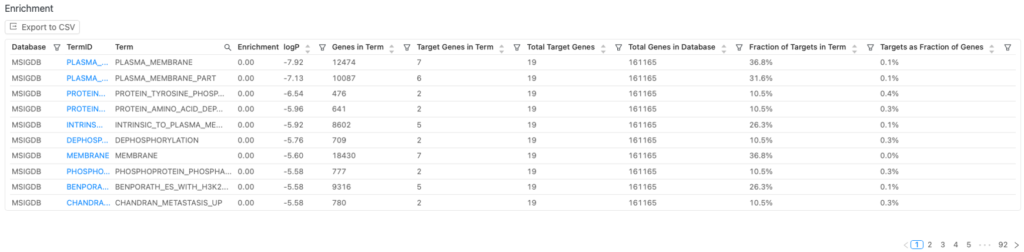
図9では、ピークに関連する遺伝子のエンリッチメント解析結果を示します。
用語
| 用語 | 定義 |
| Database | エンリッチメント解析で使用される遺伝子セットのデータベース |
| TermID | 遺伝子セットのデータベースにおける固有の識別子 |
| Term | 遺伝子セットの名前 |
| Enrichment logP | 遺伝子セットのエンリッチメントの有意性 (対数変換したp値) |
| Genes in Term | 遺伝子セットに含まれる遺伝子の総数 |
| Target Genes in Term | データセットと遺伝子セットの間で共通の遺伝子の数 |
| Total Target Genes | データセットに含まれる遺伝子の総数 |
| Total Genes in Database | 遺伝子セットのデータベースに含まれる総遺伝子数 |
| Fraction of Targets in Term | データセットに含まれる全遺伝子数の内、遺伝子セットで共通する遺伝子の割合 (Target Genes in Term / Total Target Genes) |
| Targets as Fraction of Genes | 遺伝子セットに含まれる全遺伝子の内、データセットに含まれる遺伝子の割合 (Target Genes in Term / Genes in Term) |
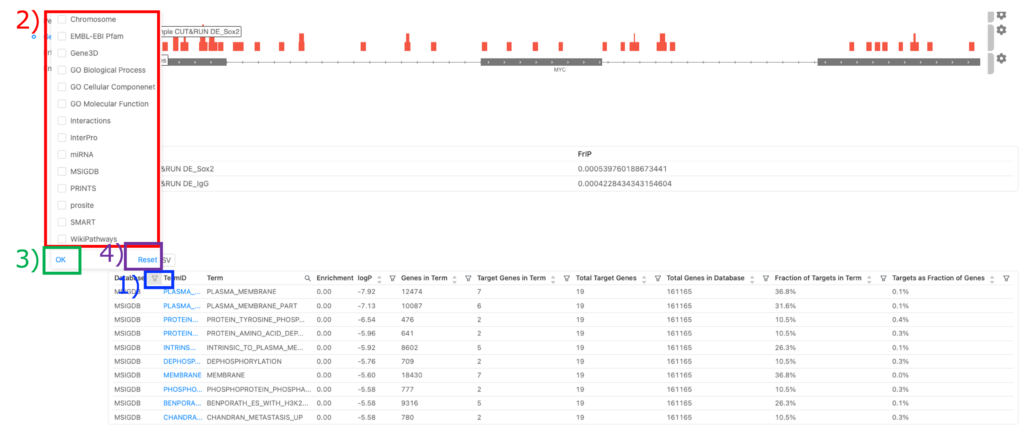
エンリッチメント解析に使用するデータベースの変更:
1) Enrichment 表の「Database」タブにある「filter」アイコンをクリックしてください。
2) データベースをチェックしてください。
3) 「OK」をクリックしてください。
4) デフォルトのデータベース (例:MSIGDB) に戻したい場合は、「Reset」をクリックし、チェックしたすべてのデータベースのチェックを外してください。
Motifs
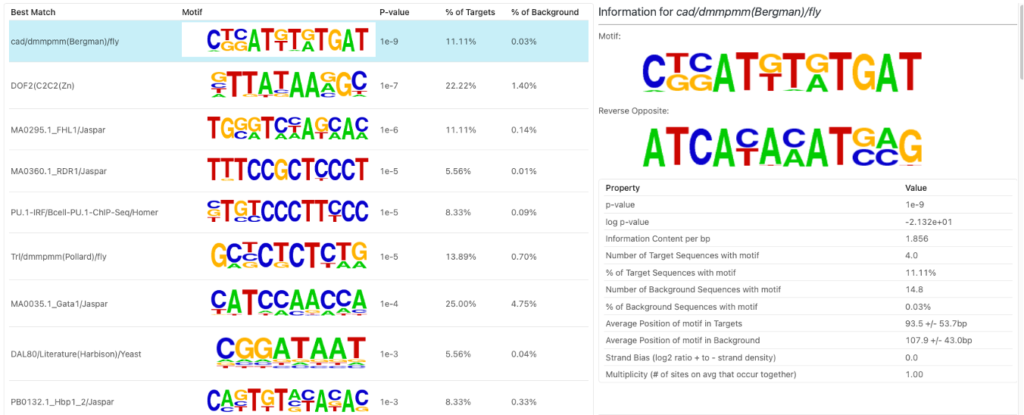
図10では、ピークでエンリッチされたモチーフのサマリーと、それらにマッチする転写因子結合プロファイルを示します。
用語
| 用語 | 定義 |
| Best Match | 発見されたモチーフに最も類似した既知のモチーフまたは転写因子結合プロファイル |
| Motif | 発見されたモチーフの配列ロゴ。背の高い文字は、その位置のヌクレオチドの保存性が高いことを示します |
| p-value | モチーフエンリッチメントの統計的有意性 |
| % of Targets | モチーフを含むピーク領域 (ターゲット) の割合 |
| % of Background | モチーフを含むバックグラウンド領域 (非ピーク領域) の割合 |
図10の左側のモチーフをクリックすると、詳細なサマリーが右側に表示されます。図10の詳細については、以下のテクニカルノートをご参照ください。
basepairでのエピジェネティクスデータのモチーフ探索とアノテーション
アウトプットファイル (「Input/output」タブ)
「Input/output」タブ (赤枠) から確認できます。
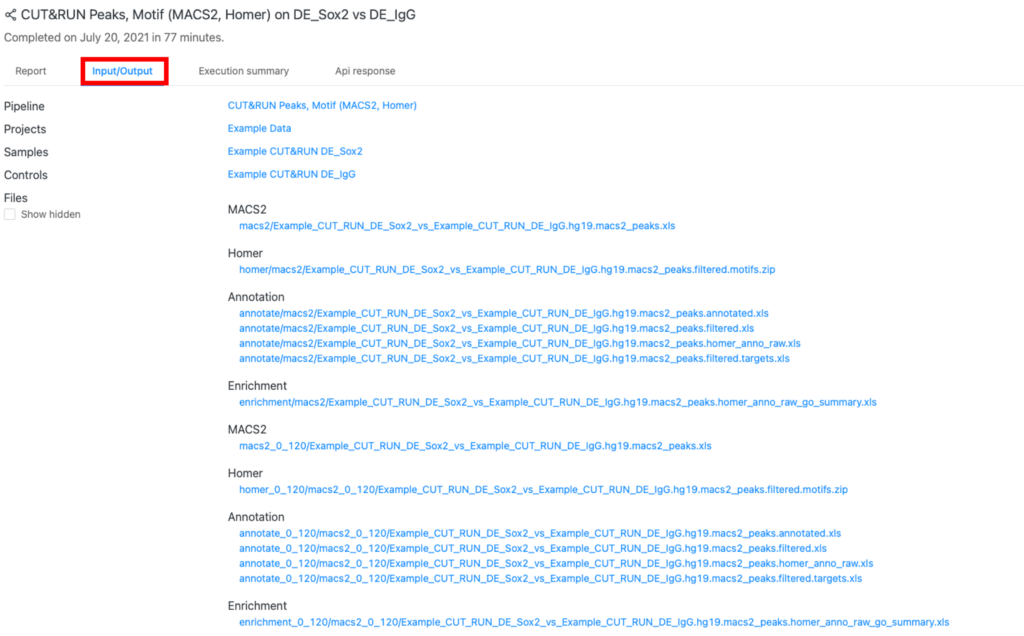
MACS2
- MACSから出力されたピークコールの生データ (Excel形式)
(macs2/<ANALYSIS_NAME>.< genome>. macs2_peaks.xls)
Homer
- 解析で同定されたすべてのモチーフ (Json形式)
(homer_view/all_motif_data.json)
- 解析で同定された個々のモチーフのデータ (Json形式)
(home r_view/individual_motif_data.json)
- HOMEの解析結果の圧縮フォルダ (zip形式)
(home r_view/macs2/< ANALYSIS_NAME>.< genome>.macs2_peaks.filtered.motifs.zip)
Annotation
- 近傍遺伝子にアノテーションされたピークの生データ (Excel形式)
(annotate/macs2/<ANALYSIS_NAME>.<genome>.macs2_peaks.annotated.xls)
- ブラックリストに載った領域を除いた残りのピーク (Excel形式)
(annotate/macs2/<ANALYSIS_NAME>.<genome>.macs2_peaks.filtered.xls)
- HOMERにより同定されたピークとそのアノテーション (Excel形式)
(annotate/macs2/<ANALYSIS_NAME>.<genome>.macs2_peaks.homer_anno_raw.xls)
- HOMERでフィルタリングされたピークとそのアノテーション (Excel形式)
(annotate/macs2/<ANALYSIS_NAME>.<genome>.macs2_peaks.filtered.targets.xls)
Enrichment
- 遺伝子オントロジーエンリッチメントの結果 (Excel形式)
(enrichment/macs2/<ANALYSIS_NAME>.<genome>.macs2_peaks.homer_anno_raw_go_summary.xls)
Bigwigsummary
- 解析に使用した全サンプルのピークの正規化されたリードカウントデータ(npz形式)
(multiBigwigSummary/readCounts.npz)
- 解析に使用した全サンプルのピークの正規化されたリードカウントデータ (タブ区切り形式)
(multiBigwigSummary/readCounts.tab)
Plot Correlation
- 異なるサンプル間の相関を示したマトリックス (タブ区切り形式)
(plotCorrelation_heatmap/outFileCorMatrix.tab)
- 異なるサンプル間の相関を示したのヒートマップ (png形式)
(plotCorrelation_heatmap/heatmap.plotCorrelation.png)
- 異なるサンプル間の相関を示したの散布図 (png形式)
(plotCorrelation_scatterplot/scatterplot.plotCorrelation.png)
MACS2
- MACS2から出力された0~120 bpのピークコールの生データ (Excel形式)
(macs2_0_120/<ANALYSIS_NAME>.<genome>. macs2_peaks.xls)
Homer
- 0~120bpの全モチーフのデータ (Json形式)
(homer_0_120/all_motif_data.json)
- 0~120bpの各モチーフのデータ (Json形式)
(homer_0_120/individual_motif_data.json)
- HOMERによる解析結果の圧縮フォルダ (zip形式)
(homer_0_120/<ANALYSIS_NAME>.<genome>.macs2_peaks.filtered.motifs.zip)
Annotation
- 近傍遺伝子にアノテーションされた0~120bpをピーク (Excel形式)
(annotate_0_120/macs2_0_120/<ANALYSIS_NAME>.<genome>.macs2_peaks.annotated.xls)
- ブラックリストに載った領域を除いた残りの0~120bpのピーク (Excel形式)
(annotate_0_120/macs2_0_120/<ANALYSIS_NAME>.<genome>.macs2_peaks.filtered.xls)
- HOMERにより同定された0~120bpのピークとそのアノテーション (Excel形式)
(annotate_0_120/macs2_0_120/<ANALYSIS_NAME>.<genome>.macs2_peaks.homer_anno_raw.xls)
- HOMERでフィルタリングされた0~120bpのターゲットのピーク (Excel形式)
(annotate_0_120/macs2_0_120/<ANALYSIS_NAME>.<genome>.macs2_peaks.filtered.targets.xls)
Enrichment
- 0~120bpピークに対する遺伝子オントロジーエンリッチメント解析の結果 (Excel形式)
(enrichment_0_120/macs2_0_120/<ANALYSIS_NAME>.<genome>.macs2_peaks.homer_anno_raw_go_summary.xls)
BigwigSummary
- 解析に使用した全サンプルの0~120bpのピークにおける正規化されたリードカウントデータ (npz形式)
(multiBigwigSummary_0_120/readCounts.npz)
- 解析に使用した全サンプルの0~120 bpのピークにおける正規化されたリードカウントデータ (タブ区切り形式)
(multiBigwigSummary_0_120/readCounts.tab)
Plot Correlation
- 0~120bpの異なるサンプル間の相関を示したマトリックス (タブ区切り形式)
(plotCorrelation_heatmap_0_120/outFileCorMatrix.tab)
- 0~120bpの異なるサンプル間の相関を示したのヒートマップ (png形式)
(plotCorrelation_heatmap_0_120/heatmap.plotCorrelation.png)
- 0~120bpの異なるサンプル間の相関を示したの散布図 (png形式)
(plotCorrelation_scatterplot_0_120/scatterplot.plotCorrelation.png)
MACS2
- MACS2から出力された120~700bpのピークコールの生データ (Excel形式)
(Excel形式;macs2_120_700/<ANALYSIS_NAME>.<genome>.macs2_peaks.xls)
Homer
- 120~700bpのモチーフのデータ (Json形式)
(Json形式;homer_120_700/all_motif_data.json)
- 120~700bpの個々のモチーフのデータ (Json形式)
(Json形式;homer_120_700/individual_motif_data.json)
- HOMERによる解析結果の圧縮フォルダ (zip形式)
(homer_120_700/macs2_120_700/<ANALYSIS_NAME>.<genome>.macs2_peaks.filtered.motifs.zip)
Annotation
- 近傍遺伝子にアノテーションされた120~700bpのピーク (Excel形式)
(annotate_120_700/macs2_120_700/<ANALYSIS_NAME>.<genome>.macs2_peaks.annotated.xls)
- ブラックリストに載った領域を除いた残りの120~700bpのピーク (Excel形式)
(annotate_120_700/macs2_120_700/<ANALYSIS_NAME>.<genome>.macs2_peaks.filtered.xls)
- HOMERにより同定された120~700bpのピークとそのアノテーション (Excel形式)
(annotate_120_700/macs2_120_700/<ANALYSIS_NAME>.<genome>.macs2_peaks.homer_anno_raw.xls)
- HOMERでフィルタリングされた120~700bpのターゲットピーク (Excel形式)
(annotate_120_700/macs2_120_700/<ANALYSIS_NAME>.<genome>.macs2_peaks.filtered.targets.xls)
Enrichment
- 120~700bpに対する遺伝子オントロジーエンリッチメント解析の結果 (Excel形式)
(enrichment_120_700/macs2_120_700/<ANALYSIS_NAME>.<genome>.macs2_peaks.homer_anno_raw_go_summary.xls)
BigwigSummary
- 解析に使用した全サンプルの120~700bpのピークにおける正規化されたリードカウントデータ (npz形式)
(multiBigwigSummary_120_700/readCounts.npz)
- 解析に使用した全サンプルの120~700 bpのピークにおける正規化されたリードカウントデータ (タブ区切り形式)
(multiBigwigSummary_120_700/readCounts.tab)
Plot Correlation
- 120~700bpの異なるサンプル間の相関を示したマトリックス (タブ区切り形式)
(plotCorrelation_heatmap_120_700/outFileCorMatrix.tab)
- 120~700bpの異なるサンプル間の相関を示したのヒートマップ (png形式)
(plotCorrelation_heatmap_120_700/heatmap.plotCorrelation.png)
- 120~700bpの異なるサンプル間の相関を示したの散布図 (png形式)
(plotCorrelation_scatterplot_120_700/scatterplot.plotCorrelation.png)
関連ブログ
Cut&Run and Cut&Tag 解析 https://basepairtech.jp/analysis/cutnrun-cutntag/