 iwai-chem
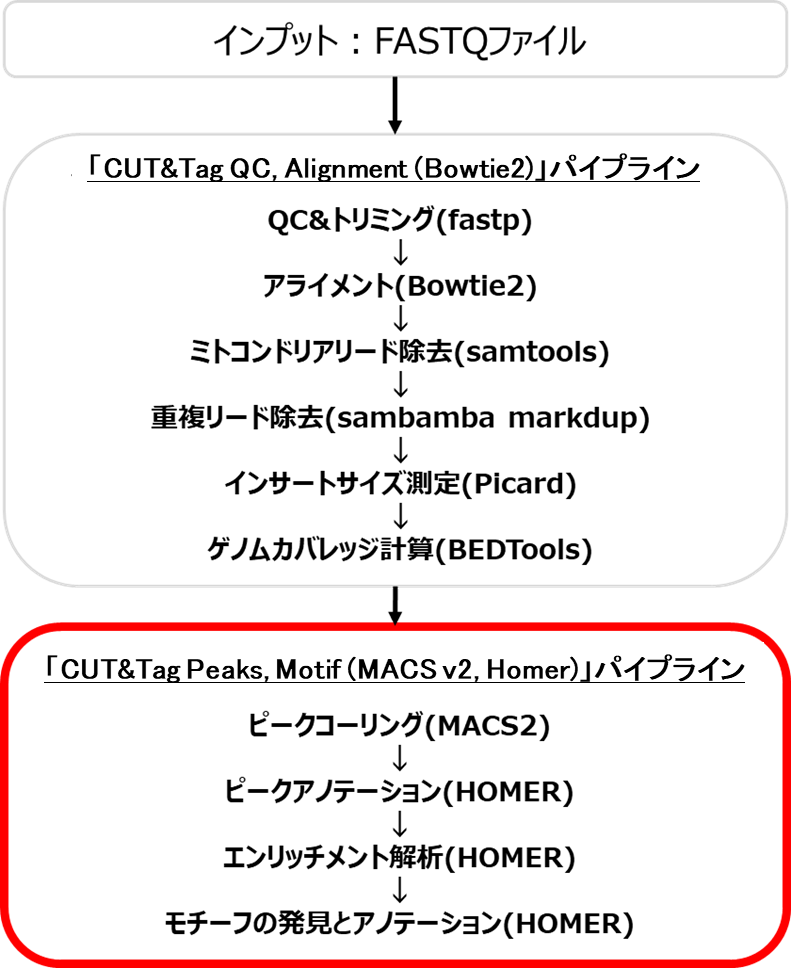
「CUT&Tag Peaks, Motif (MACS2, Homer)」パイプラインを実行すると、「CUT&Tag QC, Alignment (Bowtie2)」パイプラインが自動的に最初に実行されます。MACS2パイプラインでは、「CUT&Tag QC, Alignment (Bowtie2)」パイプラインからアウトプットされた重複リード除去済みのBAMファイルをインプットとして使用します。最初にMACS2でピークコーリングを行います。次に、HOMERでピークアノテーションとエンリッチメント解析、モチーフ解析を行います。
パイプラインのワークフロー
図1では、パイプラインのワークフローを説明しています。
ピークコーリング
MACS2を用いて、アライメントされたリードがエンリッチされたゲノム領域を特定します。これらの領域は、タンパク質の潜在的な結合部位を示しています。タンパク質には転写因子やヒストンが含まれます。
ピークのアノテーション
HOMERを用いて同定されたピークをゲノム上の特徴 (プロモーターやエンハンサーなど) と関連付けます。このことは、結合部位の機能的関連性を理解することに役立ちます。
エンリッチメント解析
HOMERを用いて、標的タンパク質の結合領域に特定の生物学的経路や遺伝子セットがエンリッチされているかどうかを判定するために実行します。
モチーフの探索とアノテーション
モチーフとは、同定されたピーク内に見られる短いDNA配列のことです。これらのモチーフは、タンパク質がDNAと結合するゲノムの領域を表しています。例えば、そのタンパク質には転写因子やDNA結合タンパク質が含まれます。ここでは、統計的に過剰に発現しているモチーフがHOMERを用いて同定されます。次に、エンリッチされたモチーフを既知のモチーフにアノテーションされます。
結果(「Report」タブ)
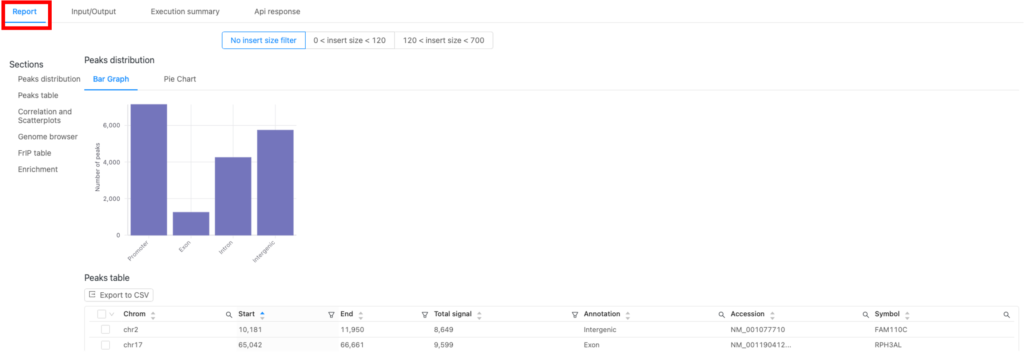
結果は、「Report」タブ(図2の赤枠)にあります。
Peaks distribution
図3aと3bでは、異なるゲノム領域に見られるピークの分布を棒グラフと円グラフで示します。この領域にはプロモーター、エクソン、イントロン、遺伝子間領域が含まれます。
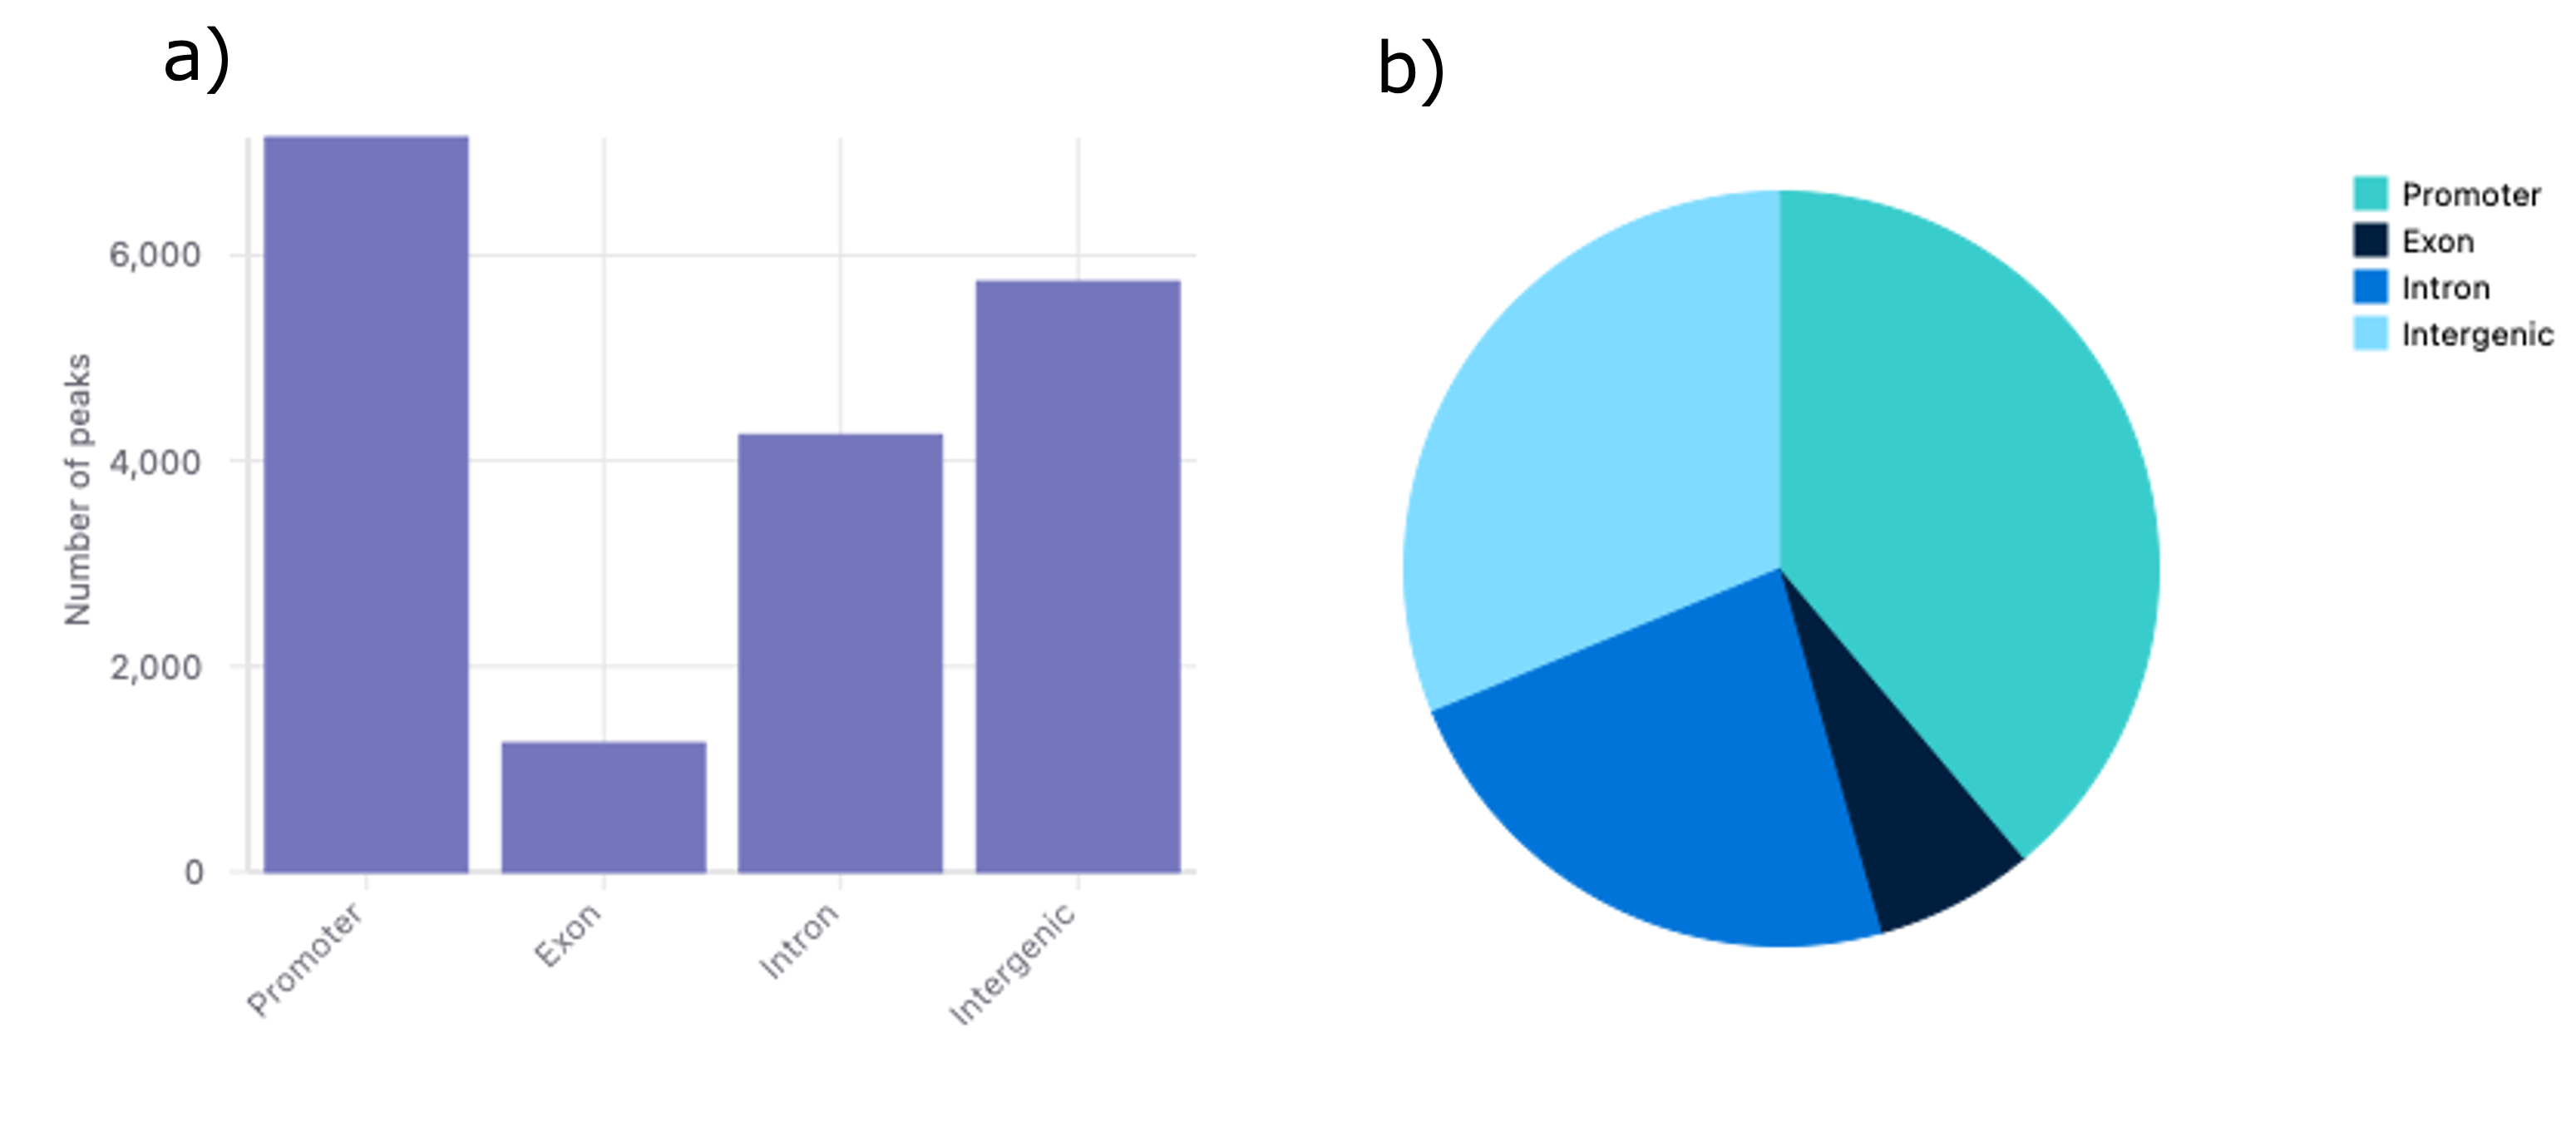
図3aでは、プロモーター領域のピーク数が最も多いです (~7,000)。つまり、タンパク質結合部位のかなりの部分が転写開始点 (TSS) の近くに位置していることを示唆しています。
また、イントロン領域 (~4,000) と遺伝子間領域 (~6,000) でも多くのピークが見られます。これらは制御エレメントを表しています。制御エレメントにはエンハンサーやサイレンサーなどが含まれます。
一方、エクソン領域のピーク数が最も少ないです (〜1,000)。ここの結果は、エクソンがコード領域であることから想定される結果です。通常、制御エレメントは非コード領域に存在するためです。
Peaks table
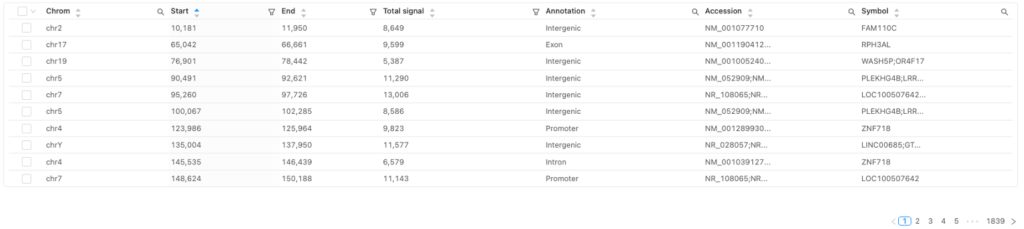
図4では、同定されたピークとその統計量、および近傍遺伝子のアノテーションを示します。
用語
| 用語 | 定義 |
| Chrom, Start, End, Length | ゲノム座標とピークの大きさ |
| Pileup | ピーク頂上のゲノム位置にアライメントされたリード数 |
| Pval | ピークの統計的な有意性 ( -10 * log10 ) |
| Qval | 偽発見率(FDR)で補正した統計的な有意性 ( -10 * log10 ) |
| Fold | ピークのエンリッチメント度。バックグラウンドに対してどれくらいエンリッチしているかを表す |
| Annotation | ピークが位置するゲノム特徴 |
| Accession | ピークに最も近い遺伝子のID |
| Symbol | ピークに最も近い遺伝子の記号・名前 |
Correlation and scatterplots
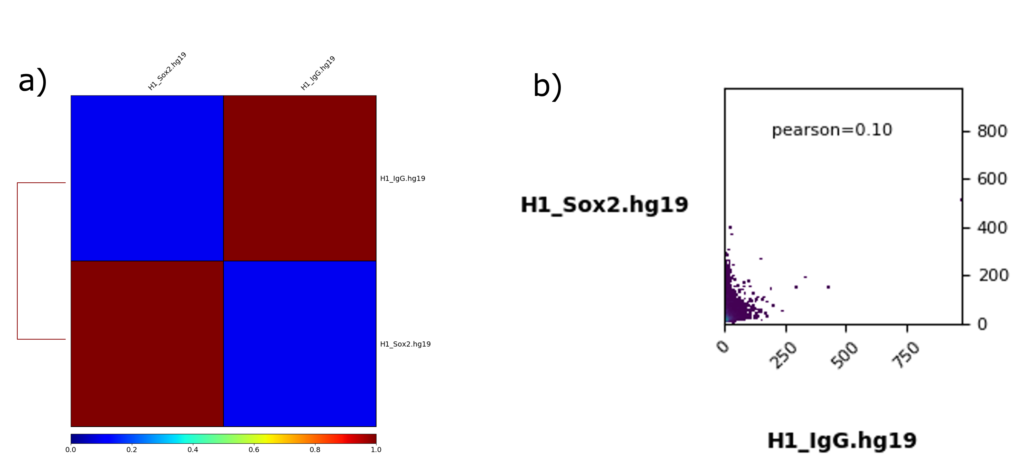
相関解析から得られたヒートマップと散布図をそれぞれ図5aと5bに示します。
ヒートマップ
図5aのヒートマップでは、異なるサンプル間の相関を表しています。下部のカラースケールは相関の強さを示しています。青は相関が低い、または相関がないことを表し、赤は相関が高いことを表します。
Sox2 (転写因子)とIgG (コントロール) のヒートマップにおける色の違いは、2つのサンプルの相関が弱いことを示しています。これは一方が特定のターゲット (Sox2) で、もう一方がコントロール (IgG) である場合にみられます
散布図
図5bの散布図では、サンプルペア間のシグナル強度を示しています。 x軸はIgGサンプルの値を表し、y軸はSox2サンプルの値を表します。散布図上の各点は、特定のゲノム上の位置 (例えば、ピークやターゲット領域) における2つのサンプル間の比較を表します。点の位置は、一方のサンプルのシグナル強度 (例えば、リードカウントまたは正規化スコア) が他方のサンプルのシグナル強度とどのように関連しているかを示します。グラフには、2つのサンプル間の相関を測定するピアソン相関係数の数値が含まれます (例えば、pearson = 0.43)。通常、係数は-1から1の範囲です。
ヒートマップの結果 (図5a) と同様に、図5bのピアソン相関係数0.10は、2つのサンプル間の相関が弱いことを示しています。
Genome browser
図6では、Integrative Genomics Viewer (IGV) でシグナル強度を視覚化した例を示します。
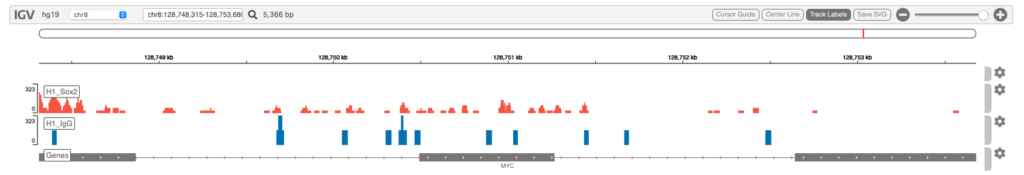
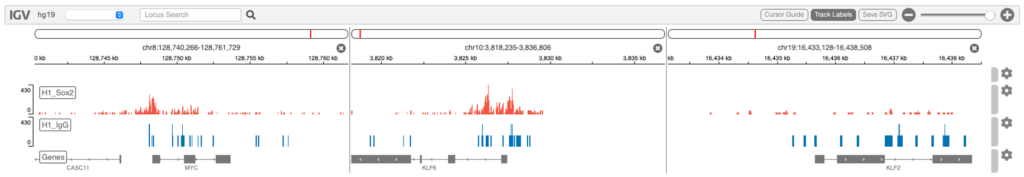
検索ボックスで、間にスペースを入れて複数の遺伝子を指定することで、並べて可視化することができます。
例えば以下の図7のような表示にできます。

FRiP table
FRiP (Fraction of Reads in Peaks) は、実験のクオリティを評価する指標です。
FRiPは、同定されたピークにマップされたリード数を、リードの総数で割ることによって計算されます:
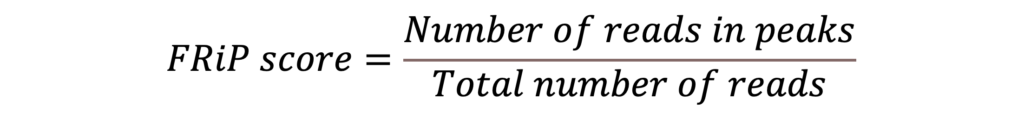
一般的に、FriPスコアが高いほど標的タンパク質とDNAの相互作用が強くエンリッチされており、ピーク内のリードの割合が高いことを示します。

図8では、Sox2サンプルとIgGサンプルのFRiPスコアはそれぞれ約0.3と0.09でした。これは、Sox2サンプルとIgGサンプルの全リードの約30%と9%が、同定されたピーク内にあることを示しています。Sox2のFriPスコアが高いことは、タンパク質-DNA相互作用がエンリッチされていることを示しています。一方、IgGはコントロールサンプルであり、タンパク質-DNA相互作用は多くないため、FriPスコアが低くなることが予想されます。
Enrichment
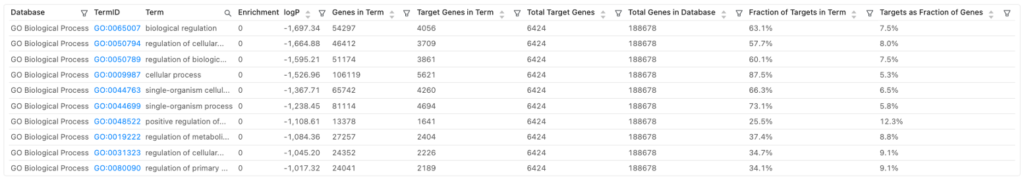
図9では、ピークに関連する遺伝子のエンリッチメント解析結果を示します。
用語
| 用語 | 定義 |
| Database | エンリッチメント解析で使用される遺伝子セットのデータベース |
| TermID | 遺伝子セットのデータベースにおける固有の識別子 |
| Term | 遺伝子セットの名前 |
| Enrichment logP | 遺伝子セットのエンリッチメントの有意性 (対数変換したp値) |
| Genes in Term | 遺伝子セットに含まれる遺伝子の総数 |
| Target Genes in Term | データセットと遺伝子セットの間で共通の遺伝子の数 |
| Total Target Genes | データセットに含まれる遺伝子の総数 |
| Total Genes in Database | 遺伝子セットデータベースの総遺伝子数 |
| Fraction of Targets in Term | データセットに含まれる全遺伝子数の内、遺伝子セットで共通する遺伝子の割合 (Target Genes in Term / Total Target Genes) |
| Targets as Fraction of Genes | 遺伝子セットに含まれる全遺伝子の内、データセットに含まれる遺伝子の割合 (Target Genes in Term / Genes in Term) |
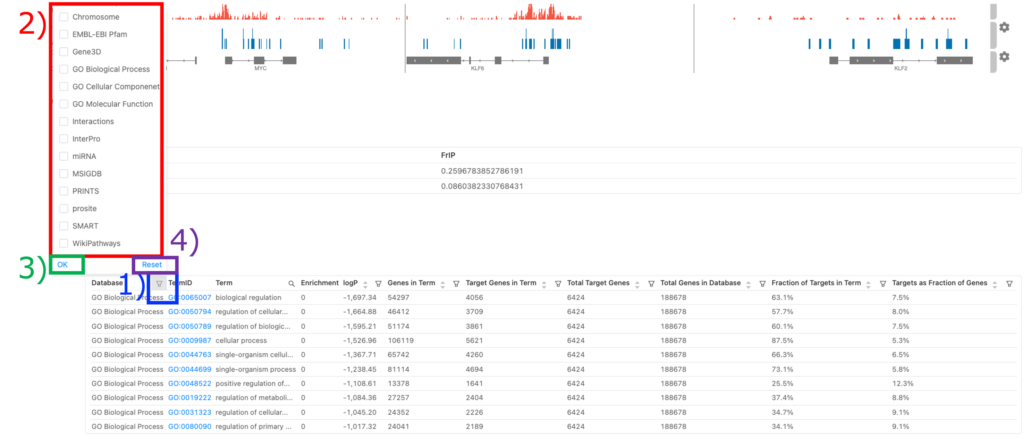
エンリッチメント解析に使用するデータベースの変更:
1) Enrichment 表の「Database」タブにある「filter」アイコンをクリックしてください。
2) データベースをチェックしてください。
3) 「OK」をクリックしてください。
4) デフォルトのデータベース (例:GO Biological Process) に戻りたい場合は、「Reset」をクリックし、チェックしたすべてのデータベースのチェックを外してください。
Motifs
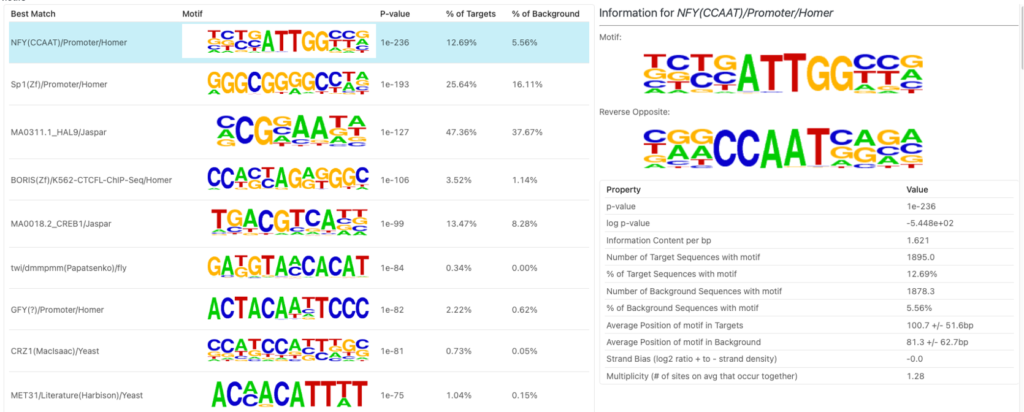
図10では、ピークでエンリッチされたモチーフのサマリーと、それらにマッチする転写因子結合プロファイルを示します。
用語
| 用語 | 定義 |
| Best Match | 発見されたモチーフに最も類似した既知のモチーフまたは転写因子結合プロファイル |
| Motif | 発見されたモチーフの配列ロゴ。背の高い文字は、その位置のヌクレオチドの保存性が高いことを示します |
| p-value | モチーフエンリッチメントの統計的有意性 |
| % of Targets | モチーフを含むピーク領域 (ターゲット) の割合 |
| % of Background | モチーフを含むバックグラウンド領域 (非ピーク領域) の割合 |
図10の左側のモチーフ (例えば、NFY転写因子のベストマッチ) をクリックすると、そのモチーフの詳細なサマリーが右側に表示されます。図10のエンリッチされたモチーフの詳細については、テクニカルノート 「Basepair上のエピジェネティクスデータのモチーフ探索とアノテーション」をご参照ください。
アウトプットファイル (「Input/output)タブ)
アウトプットファイルは、「Input/output」タブ (赤枠) にあります。
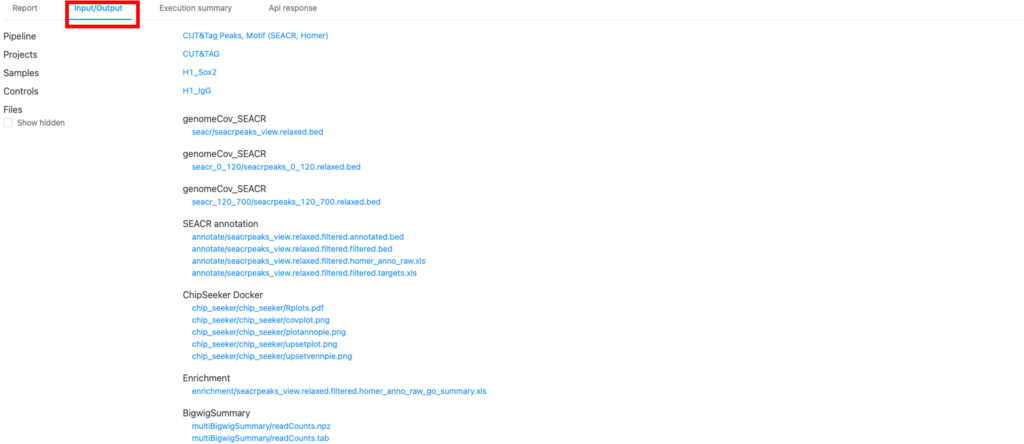
MACS2
- MACSから出力されたピークコールの生データ (Excel形式)
(macs2/<ANALYSIS_NAME>.< genome>. macs2_peaks.xls)
Homer
- 解析で同定されたすべてのモチーフ (Json形式)
(homer_view/all_motif_data.json)
- 解析で同定された個々のモチーフのデータ (Json形式)
(homer_view/individual_motif_data.json)
- HOMEの解析結果の圧縮フォルダ
(homer_view/macs2/< ANALYSIS_NAME>.< genome>.macs2_peaks.filtered.motifs.zip)
Annotation
- 近傍遺伝子にアノテーションされたピークの生データ (Excel形式)
(annotate/macs2/<ANALYSIS_NAME>.<genome>.macs2_peaks.annotated.xls)
- ブラックリストに載った領域を除いた残りのピーク (Excel形式)
(annotate/macs2/<ANALYSIS_NAME>.<genome>.macs2_peaks.filtered.xls)
- HOMERにより同定されたピークとそのアノテーション (Excel形式)
(annotate/macs2/<ANALYSIS_NAME>.<genome>.macs2_peaks.homer_anno_raw.xls)
- HOMERでフィルタリングされたピークとそのアノテーション (Excel形式)
(annotate/macs2/<ANALYSIS_NAME>.<genome>.macs2_peaks.filtered.targets.xls)
ChipSeeker Docker
- 特定の遺伝子要素に近接したピークの割合を示す円グラフ (PDF形式)
(chip_seeker/chip_seeker/Rplots.pdf)
- 各染色体上で見つかったピークを可視化したグラフ (png形式)
(chip_seeker/chip_seeker/covplot.png)
- 特定の遺伝子要素に近接したピークの割合を示す円グラフ (png形式)
(chip_seeker/chip_seeker/plotannopie.png)
- 特定の遺伝子要素に近接するピークのアップセットプロット (png形式)
(chip_seeker/chip_seeker/upsetplot.png)
- 円グラフとアップセットプロットの両方を組み合わせたプロット (png形式)
(chip_seeker/chip_seeker/upsetvennpie.png)
Enrichment
- 遺伝子オントロジーエンリッチメント結果 (Excel形式)
(enrichment/macs2/<ANALYSIS_NAME>.<genome>.macs2_peaks.homer_anno_raw_go_summary.xls)
BigwigSummary
- 解析に使用した全サンプルのピークの正規化されたリードカウントデータ (npz形式)
(multiBigwigSummary/readCounts.npz)
- 解析に使用した全サンプルのピークの正規化されたリードカウントデータ (タブ区切り形式)
(multiBigwigSummary/readCounts.tab)
Plot Correlation
- 異なるサンプル間の相関を示したマトリックス (タブ区切り形式)
(plotCorrelation_heatmap/outFileCorMatrix.tab)
- 異なるサンプル間の相関を示したのヒートマップ (png形式)
(plotCorrelation_heatmap/heatmap.plotCorrelation.png)
- 異なるサンプル間の相関を示したの散布図 (png形式)
(plotCorrelation_scatterplot/scatterplot.plotCorrelation.png)
MACS2
- MACS2から出力された0~120 bpのピークコールの生データ (Excel形式)
(macs2_0_120/<ANALYSIS_NAME>.<genome>. macs2_peaks.xls)
Homer
- 0~120bpの全モチーフのデータ (Json形式)
(homer_0_120/all_motif_data.json)
- 0~120bpの各モチーフのデータ (Json形式)
(homer_0_120/individual_motif_data.json)
- HOMERによる解析結果の圧縮フォルダ
(homer_0_120/<ANALYSIS_NAME>.<genome>.macs2_peaks.filtered.motifs.zip)
Annotation
- 近傍遺伝子にアノテーションされた0~120bpをピーク (Excel形式)
(annotate_0_120/macs2_0_120/<ANALYSIS_NAME>.<genome>.macs2_peaks.annotated.xls)
- ブラックリストに載った領域を除いた残りの0~120bpのピーク (Excel形式)
(annotate_0_120/macs2_0_120/<ANALYSIS_NAME>.<genome>.macs2_peaks.filtered.xls)
- HOMERにより同定された0~120bpのピークとそのアノテーション (Excel形式)
(annotate_0_120/macs2_0_120/<ANALYSIS_NAME>.<genome>.macs2_peaks.homer_anno_raw.xls)
- HOMERでフィルタリングされた0~120bpのターゲットのピーク (Excel形式)
(annotate_0_120/macs2_0_120/<ANALYSIS_NAME>.<genome>.macs2_peaks.filtered.targets.xls)
Enrichment
- 0~120bpピークに対する遺伝子オントロジーエンリッチメント解析の結果 (Excel形式)
(enrichment_0_120/macs2_0_120/<ANALYSIS_NAME>.<genome>.macs2_peaks.homer_anno_raw_go_summary.xls)
BigwigSummary
- 解析に使用した全サンプルの0~120bpのピークにおける正規化されたリードカウントデータ (npz形式)
(multiBigwigSummary_0_120/readCounts.npz)
- 解析に使用した全サンプルの0~120 bpのピークにおける正規化されたリードカウントデータ (タブ区切り形式)
(multiBigwigSummary_0_120/readCounts.tab)
Plot Correlation
- 0~120 bpの異なるサンプル間の相関を示したマトリックス (タブ区切り形式)
(plotCorrelation_heatmap_0_120/outFileCorMatrix.tab)
- 0~120 bpの異なるサンプル間の相関を示したヒートマップ (png形式)
(plotCorrelation_heatmap_0_120/heatmap.plotCorrelation.png)
- 0~120 bpの異なるサンプル間の相関を示した散布図 (png形式)
(plotCorrelation_scatterplot_0_120/scatterplot.plotCorrelation.png)
MACS2
- MACS2から出力された120~700bpのピークコールの生データ (Excel形式)
(Excel形式;macs2_120_700/<ANALYSIS_NAME>.<genome>.macs2_peaks.xls)
Homer
- 120~700bpのモチーフのデータ (Json形式)
(homer_120_700/all_motif_data.json)
- 120~700bpの個々のモチーフのデータ (Json形式)
(homer_120_700/individual_motif_data.json)
- HOMERによる解析結果の圧縮フォルダ
(homer_120_700/macs2_120_700/<ANALYSIS_NAME>.<genome>.macs2_peaks.filtered.motifs.zip)
Annotation
- 近傍遺伝子にアノテーションされた120~700bpのピーク (Excel形式)
(annotate_120_700/macs2_120_700/<ANALYSIS_NAME>.<genome>.macs2_peaks.annotated.xls)
- ブラックリストに載った領域を除いた残りの120~700bpのピーク (Excel形式)
(annotate_120_700/macs2_120_700/<ANALYSIS_NAME>.<genome>.macs2_peaks.filtered.xls)
- HOMERにより同定された120~700bpのピークとそのアノテーション (Excel形式)
(annotate_120_700/macs2_120_700/<ANALYSIS_NAME>.<genome>.macs2_peaks.homer_anno_raw.xls)
- HOMERでフィルタリングされた120~700bpのターゲットピーク (Excel形式)
(annotate_120_700/macs2_120_700/<ANALYSIS_NAME>.<genome>.macs2_peaks.filtered.targets.xls)
Enrichment
- 120~700bpに対する遺伝子オントロジーエンリッチメント解析の結果 (Excel形式)
(enrichment_120_700/macs2_120_700/<ANALYSIS_NAME>.<genome>.macs2_peaks.homer_anno_raw_go_summary.xls)
BigwigSummary
- 解析に使用した全サンプルの120~700bpのピークにおける正規化されたリードカウントデータ (npz形式)
(multiBigwigSummary_120_700/readCounts.npz)
- 解析に使用した全サンプルの120~700 bpのピークにおける正規化されたリードカウントデータ (タブ区切り形式)
(multiBigwigSummary_120_700/readCounts.tab)
Plot Correlation
- 120~700 bpの異なるサンプル間の相関を示したマトリックス (タブ区切り形式)
(plotCorrelation_heatmap_120_700/outFileCorMatrix.tab)
- 120~700 bpの異なるサンプル間の相関を示したヒートマップ (png形式)
(plotCorrelation_heatmap_120_700/heatmap.plotCorrelation.png)
- 120~700 bpの異なるサンプル間の相関を示した散布図 (png形式)
(plotCorrelation_scatterplot_120_700/scatterplot.plotCorrelation.png)